Straft Google KI-Inhalte ab? Was die Quellen sagen
Google verbietet Inhalte nicht allein deshalb, weil KI an ihrer Erstellung beteiligt war. Die veröffentlichten Leitlinien erlauben einen angemessenen Einsatz von KI und stellen hilfreiche, originelle Inhalte in den Mittelpunkt, während die Spamrichtlinien den Missbrauch skalierter Inhalte verbieten. Diese Richtlinie verrät nicht jede Erkennungsmethode innerhalb der Suche. Beurteilen Sie einen Artikel nach seiner Richtigkeit, seinen Belegen und seinem Wert für den Leser, statt den Wert eines kommerziellen Detektors als Ranking-Urteil von Google zu behandeln.
Fragen Sie die meisten Marketer, ob Google KI-Inhalte abstraft, und Sie bekommen ein selbstbewusstes Ja. Fragen Sie, woher das kommt, und die Spur führt über Blogartikel, die andere Blogartikel zitieren, zurück zu einer Ankündigung vom März 2024, die das Gegenteil von dem sagt, wofür sie zitiert wird.
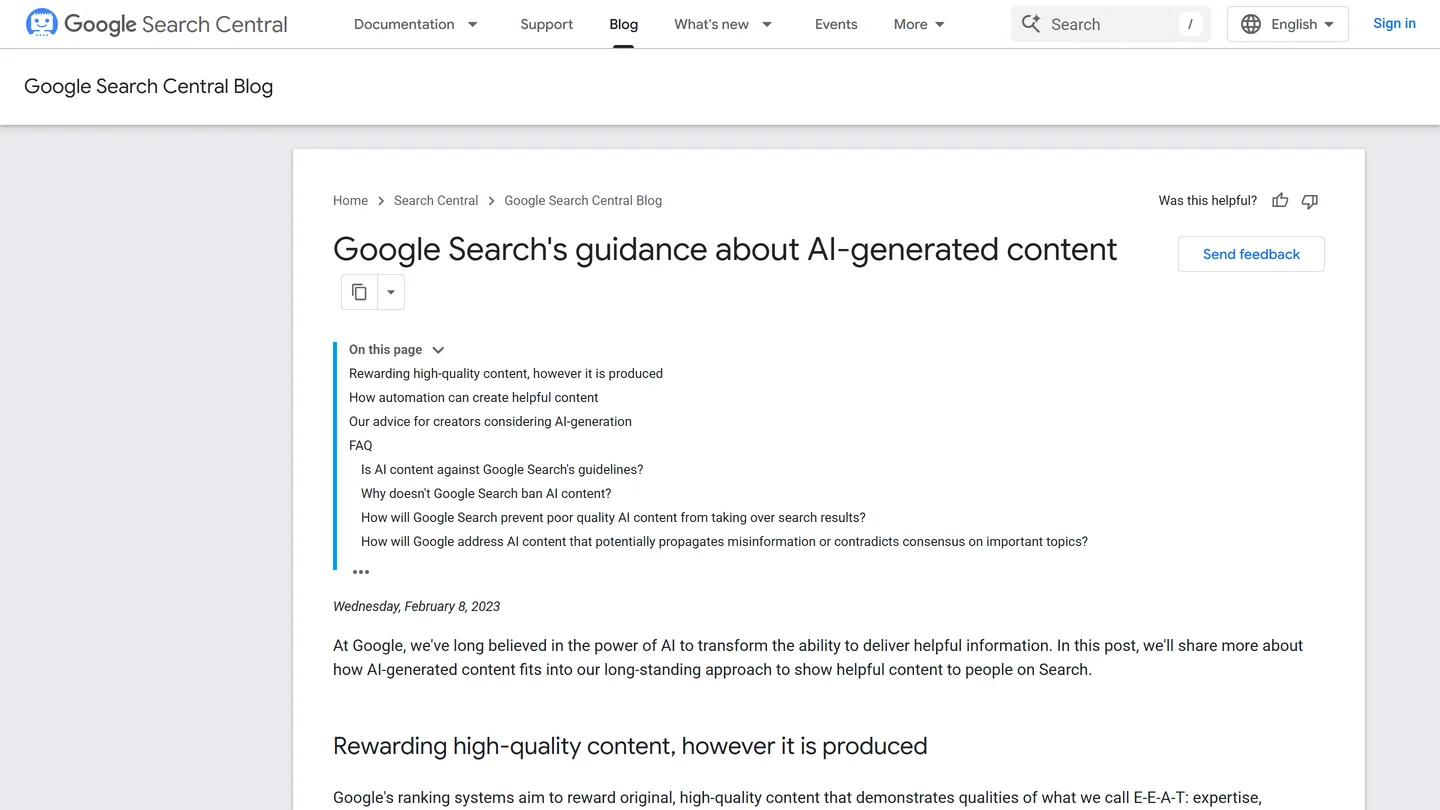
Wir haben die Primärquellen gelesen: Googles Seite mit den Spamrichtlinien, die 182 Seiten starken Search Quality Rater Guidelines, die Ankündigung zum Missbrauch skalierter Inhalte und die begutachtete Fachliteratur zur Erkennung. Die Antwort ist klarer, als die Debatte vermuten lässt, und sie verlagert die Arbeit an eine nützlichere Stelle.
Die wichtigsten Erkenntnisse
- Googles Rater-Richtlinien weisen die menschlichen Bewerter ausdrücklich an, Seiten zu bewerten, ohne festzustellen, ob KI beteiligt war. Abschnitt 4.6.5 verlangt, skalierte Inhalte ohne Mehrwert mit „Lowest“ zu bewerten, „auch wenn Sie sich über die Erstellungsmethode nicht sicher sind“.
- Googles veröffentlichte Leitlinien zu KI-Inhalten erlauben einen angemessenen Einsatz. Seiten in großem Umfang ohne Mehrwert zu produzieren, kann trotzdem gegen die Spamrichtlinien verstoßen.
- 86,5 % der am besten rankenden Seiten enthalten KI-generierten Text, und die Korrelation zwischen KI-Anteil und Ranking-Position beträgt 0,011. Über 600 000 Seiten hinweg ist das praktisch null.
- Auch KI-Detektoren können die Frage nicht klären. Sieben von ihnen stuften Aufsätze von Nicht-Muttersprachlern mit einer durchschnittlichen Quote von 61,22 % fälschlich als KI ein, und Paraphrasieren senkt die Erkennung von 70 % auf unter 5 %.
- Textwasserzeichen gibt es inzwischen. Gemini trägt eines seit 2024, Claude seit dem 14. August 2026. Nur der Anbieter, der den Text erzeugt hat, kann das Zeichen lesen, Googles Verifizierung in der Suche umfasst Bilder, Audio und Video, und eine Nutzung fürs Ranking wurde nicht veröffentlicht.
- Die Messlatte, die wirklich zählt, ist menschlich. Fünf Vielnutzer von Large Language Models (LLM) klassifizierten gemeinsam abstimmend 299 von 300 Artikeln richtig. Das Merkmal, das sie nannten, war nicht das Vokabular, sondern die Originalität.
Was Googles eigene Dokumente sagen
Beginnen wir mit dem stärksten Beleg, den fast niemand zitiert: den Search Quality Rater Guidelines. Das sind die Anweisungen, die Google den Menschen gibt, die Suchergebnisse bewerten. Diese Bewerter haben pro Seite weit mehr Zeit als jeder Crawler, und man sagt ihnen, sie sollen sich nicht mit der Herkunft aufhalten.
Aus Abschnitt 4.6.5 der Ausgabe vom 11. September 2025:
„Seiten und Websites, die aus in großem Umfang erstellten Inhalten ohne originelle Inhalte oder Mehrwert für Nutzer bestehen, sollten mit ‚Lowest‘ bewertet werden, unabhängig davon, wie sie erstellt wurden. Auch wenn Sie sich über die Erstellungsmethode nicht sicher sind, z. B. ob die Seite mit generativen KI-Tools erstellt wurde oder nicht, sollten Sie dennoch die Bewertung ‚Lowest‘ vergeben, wenn Sie stark einen Missbrauch skalierter Inhalte vermuten.“
Abschnitt 4.6.6 ist genauso direkt: „Die Nutzung generativer KI-Tools allein bestimmt weder den Aufwand noch die Bewertung der Seitenqualität.“
Das ist eine Anweisung zur Qualitätsbewertung. Ein Bewerter kann skalierte Inhalte ohne Mehrwert beurteilen, ohne ihre Herkunft festzustellen. Sie verrät uns nicht, welche internen Signale Googles automatisierte Systeme nutzen.
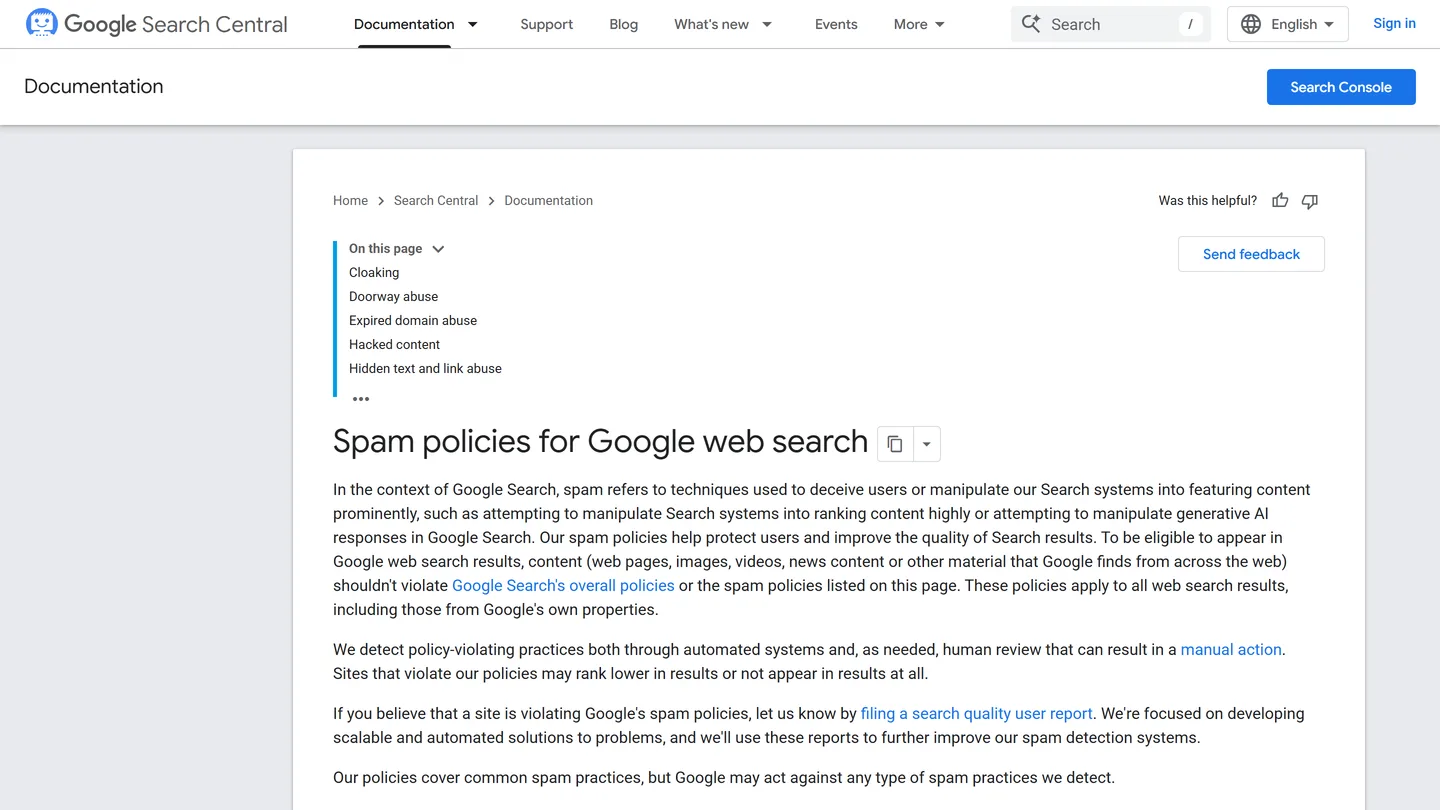
Googles Spamrichtlinien behandeln den Missbrauch skalierter Inhalte, Cloaking, Brückenseiten und andere manipulative Praktiken. Der Abschnitt zu skalierten Inhalten umfasst den Einsatz generativer KI, um viele Seiten ohne Mehrwert zu erzeugen. Die Leitlinien zu KI-Inhalten unterscheiden angemessenen Einsatz von Inhalten, die in erster Linie zur Manipulation von Rankings erzeugt werden.
Jedes Wort vor „ohne Mehrwert“ trägt weniger, als Sie denken. Der Verstoß liegt in der Masse und der Leere.
Dann ist da die Ankündigung vom März 2024 selbst, die meist als Durchgreifen gegen KI zitiert wird. Sie sagt zweimal „unabhängig davon, wie er erstellt wurde“. Googles eigene FAQ im selben Beitrag erklärt, warum die Richtlinie neu formuliert wurde:
„Sie wurde erweitert, um ausgefeiltere Methoden zur Erstellung skalierter Inhalte zu erfassen, bei denen nicht immer klar ist, ob minderwertige Inhalte rein durch Automatisierung entstanden sind.“
Das erklärt, warum die Richtlinie Missbrauch unabhängig von der Entstehungsweise erfasst. Es ist kein Beleg dafür, dass Google keine Erkennungsfähigkeit hat oder dass alle KI-gestützten Inhalte ranken werden.
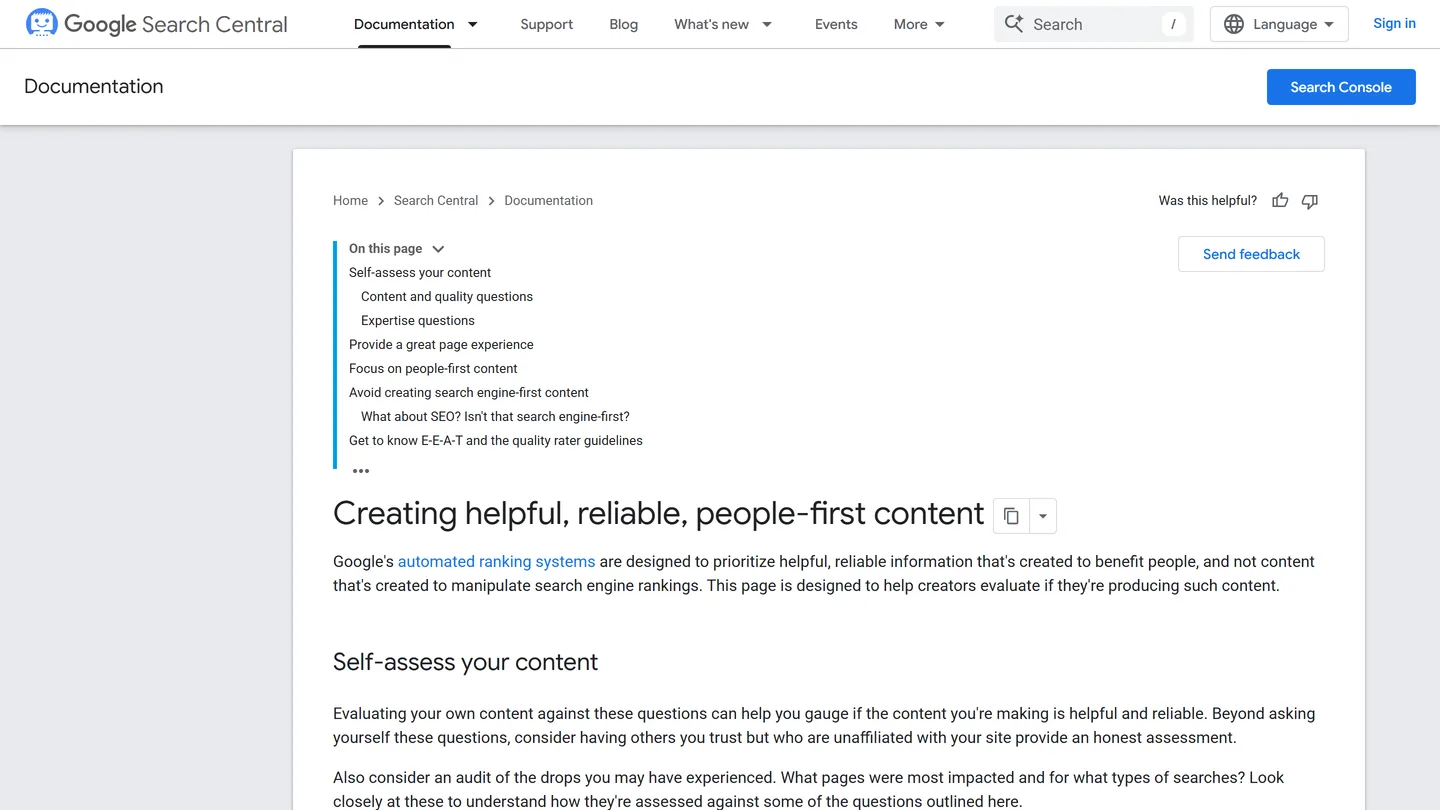
Die Bewertungen der Rater berühren die Rankings ohnehin nicht. Googles Dokumentation zu hilfreichen Inhalten sagt klar, dass „Rater-Daten nicht direkt in unseren Ranking-Algorithmen verwendet werden“.
Was die Ranking-Daten zeigen
Zwei große Studien, und sie widersprechen sich. Dieser Widerspruch erweist sich als der nützlichste Befund in diesem ganzen Bereich.
| Studie | Stichprobe | Ergebnis |
|---|---|---|
| Ahrefs, Juli 2025 | 600 000 Seiten, Top 20, 100 000 Keywords | 86,5 % der am besten rankenden Seiten enthalten KI-Inhalte. Korrelation zwischen KI-Anteil und Position: 0,011 |
| Ahrefs, Juli 2026 | 1 000 000 Seiten, 100 000 Suchen | 5,3 % der Top-3-Ergebnisse sind zu 100 % KI. Der durchschnittliche KI-Wert steigt nur von 27,1 % auf Position 1 auf 30,9 % auf Position 10 |
| Semrush, April 2026 | 42 000 Blogseiten, GPTZero als Detektor | Position 1 ist zu 80,5 % menschlich, zu 10 % KI. Menschliche Inhalte ranken „8-mal wahrscheinlicher“ auf Platz 1 |
Wer sich für eine Seite entscheidet, rät. Die beiden Studien nutzten unterschiedliche Detektoren, unterschiedliche Maßeinheiten und unterschiedliche Korpora. Ahrefs bewertete Seiten nach dem prozentualen Anteil an KI-Text über alle Top-10-Ergebnisse. Semrush ließ GPTZero nur über Blogseiten laufen und verwendete ein Label auf Dokumentebene.
Der gemessene Anteil an KI-Inhalten in den Suchergebnissen hängt also weitgehend davon ab, welchen Detektor man darauf richtet. Das ist eine Tatsache über Detektoren, nicht über Google.
Ahrefs sagte das über die eigene Studie auch selbst: „Die Art, wie wir KI-Inhalte erkennen, unterscheidet sich davon, wie Google es tut.“ Das Fazit nach einer Million Seiten war noch deutlicher: „Google ist nicht gegen KI-Inhalte, sondern gegen schlechte Inhalte.“
Warum Detektoren die Frage nicht klären können
- Bei Nicht-Muttersprachlern versagen sie gründlich. Sieben Detektoren, getestet an 91 Aufsätzen aus dem TOEFL (Test of English as a Foreign Language), erzeugten eine durchschnittliche Falsch-positiv-Rate von 61,22 %, und alle sieben stuften 19,78 % davon übereinstimmend falsch ein. Bei Aufsätzen von US-Achtklässlern waren dieselben Detektoren nahezu perfekt. Veröffentlicht in Patterns von Cell Press.
- Sie versagen auf breiter Front. Ein unabhängiger Benchmark von 14 Tools ergab, dass jedes unter 80 % Genauigkeit lag, und maschinell paraphrasierter KI-Text wurde nur in 26 % der Fälle erkannt.
- Sie brechen bei trivialen Änderungen ein. Paraphrasieren senkte einen Detektor bei fester Falsch-positiv-Rate von 70,3 % auf 4,6 %. In einem Benchmark mit 6,2 Millionen Generierungen fielen zwei führende Detektoren von 100 % auf nahezu null, nur weil die Sampling-Einstellungen des Modells geändert wurden.
- Es gibt eine bewiesene Obergrenze. Ein Artikel in Transactions on Machine Learning Research (TMLR) leitet eine harte Schranke her, die die bestmögliche Genauigkeit jedes Detektors daran knüpft, wie stark sich die Verteilungen menschlicher und maschineller Texte überlappen. Je besser die Modelle werden, desto enger wird diese Schranke für alle.
- Die Anbieter wissen es. OpenAI zog seinen eigenen Klassifikator im Juli 2023 zurück und veröffentlichte eine Richtig-positiv-Rate von 26 % und eine Falsch-positiv-Rate von 9 %. Der Chief Product Officer von Turnitin räumte wenige Monate nach dem Start eine „höhere Falsch-positiv-Rate ein, als das Unternehmen ursprünglich angegeben hatte“.
Die sprachlichen Merkmale, auf die sich Detektoren stützen, sickern in menschliches Schreiben ein. Eine Studie über 737 083 Stunden ungeskriptete Podcast-Sprache in 824 634 Episoden (Yakura et al., erstmals veröffentlicht im September 2024) fand nach ChatGPT einen abrupten Anstieg genau der Wörter, die Detektoren markieren (“delve”, “showcase”, “boast”, “intricacies”, “meticulous”). Ein Detektor, der 2026 nach dem Wort “delve” sucht, erkennt zum Teil Menschen, die mit Chatbots reden.
Wo Textwasserzeichen im September 2026 stehen
Der Einwand, der „lassen Sie es durch einen Detektor laufen“ ablöst, lautet „Google versieht es mit einem Wasserzeichen“, also hier der Stand vom 13. September 2026.
Googles SynthID markiert Gemini-Text seit 2024. Am 14. August 2026 begann Anthropic, ein auf SynthID-Text basierendes Wasserzeichen in die Ausgaben von Claude einzubetten, auf allen Oberflächen einschließlich der API und ohne Opt-out, um Artikel 50 des EU AI Act zu erfüllen. Anthropics eigene Beschreibung besagt, dass leichte Bearbeitung das Zeichen meist erhält, eine vollständige Umformulierung es entfernt und kurze Passagen zu wenig Signal für eine Erkennung tragen. OpenAI wendet SynthID auf Bilder und Audio an und nennt kein Signal für Text.
Drei Fakten halten das aus der Ranking-Debatte heraus. Ein Textwasserzeichen lässt sich nur mit dem Schlüssel lesen, mit dem es erzeugt wurde, und Anthropics Detektor ist eine private Vorschau für Aufsichtsbehörden, Medien und Forschende. Googles SynthID-Verifizierung in der Suche und in Chrome, angekündigt am 19. Mai 2026, beantwortet die Frage „Ist das KI-generiert?“ für Bilder, Audio und Video. Und Google hat nichts veröffentlicht, das irgendein Wasserzeichen mit dem Ranking verknüpft; die oben zitierte Rater-Anweisung verlangt von den eigenen Bewertern weiterhin, Seiten „unabhängig davon, wie sie erstellt wurden“, zu beurteilen.
Was die Ära der Wasserzeichen ändert, ist, wie lange der Rat aus den nächsten beiden Abschnitten gilt. Eine Seite, deren einziger Beitrag die Paraphrase eines Modells ist, wird mit Mitwirkung des Anbieters irgendwann als solche erkennbar sein, und das Gesetz verlangt inzwischen, dass diese Mitwirkung möglich ist. Eine Seite, die auf Zahlen, Tests und Lektüre beruht, die kein Modell erzeugt hat, behält ihren Wert, egal welches Tool die Sätze getippt hat.
Was Inhalte tatsächlich unterdrückt
Drei Dinge. Keines davon ist die Autorschaft.
1. Masse ohne Mehrwert. Die Websites, die 2024 aus dem Index flogen, hatten ein gemeinsames, erkennbares Muster. Hunderte fast identischer URLs in einem einzigen Verzeichnis. „Ähnliche Fragen“ als Überschriften. Zusammengestückelte Fragmente, die keinen Zusammenhang ergeben. Versteckte Verzeichnisse. Anonyme Autorschaft bei Themen zu Geld und Gesundheit. Ein dokumentierter Fall hatte rund fünf Millionen URLs in einem Verzeichnis, das niemand finden sollte. Veröffentlichen Sie von Menschen geschriebene Inhalte in dieser Form, und Sie erhalten dasselbe Ergebnis.
2. Verfall. Ein kontrolliertes Experiment über 16 Monate veröffentlichte 2 000 unbearbeitete KI-Artikel auf 20 neuen Domains ohne Links und ohne Updates. 71 % wurden innerhalb von 36 Tagen indexiert, und die Präsenz in den Top 100 erreichte ihren Höchststand bei etwa 28 %. Bis zum dritten Monat war sie auf 3 % eingebrochen. Eine Abstrafung gab es nie. Die Seiten waren es einfach nicht mehr wert, angezeigt zu werden.
3. Leser. Das ist die eigentliche Messlatte, und sie liegt höher als jeder Algorithmus. Fünf Annotatoren, die LLMs häufig nutzen, klassifizierten als Gruppe abstimmend 299 von 300 Artikeln richtig. Sie blieben genau, auch gegen Paraphrasierung und gegen jedes getestete kommerzielle „Humanizer“-Tool. Gefragt, was ihnen auffiel, nannten sie Förmlichkeit, Klarheit und Originalität, keine Wörter.
Das Letzte ist das ganze Spiel, denn Originalität ist eine Eigenschaft von Information, nicht von Prosa. Kein Prompt, keine Sampling-Einstellung und kein Bearbeitungsdurchgang erzeugt eine Tatsache, die nicht schon verfügbar war. Wenn Ihr Käufer den Text liest und ihn als kompetente Neufassung der ersten drei Ergebnisse erkennt, haben Sie auf einer Dimension verloren, die kein Tool misst.
Was Sie stattdessen tun sollten
Nutzen Sie Googles veröffentlichte Leitlinien zu Qualität und Spam, um zu entscheiden, was Sie verbessern. Der Wert eines kommerziellen Detektors kann Ihnen nicht sagen, ob der Artikel die Frage des Lesers gut beantwortet.
Bringen Sie etwas auf die Seite, das es im Web noch nicht gibt. Eigene Zahlen aus Ihren Konten. Tests aus erster Hand, bei denen Sie die Sache tatsächlich durchgeführt und festgehalten haben, was passiert ist. Ein Interview mit der Person, die die Arbeit gemacht hat. Eigene Lektüre der Primärquellen, die zeigt, wo die populäre Zusammenfassung falsch lag. Wenn ein Text nichts davon hat, hat er eine Obergrenze, die kein Feinschliff anhebt.
Machen Sie die Belege leicht überprüfbar. Eine Beobachtungsstudie von 2026 über 21 143 Zitierungen fand höhere durchschnittliche Quelleneinflusswerte auf Seiten mit Statistiken, Definitionen und Vergleichen. Sie hat nicht geprüft, ob das Hinzufügen dieser Merkmale mehr Zitierungen bewirkt. Verwenden Sie eine Statistik, weil sie die Frage des Lesers beantwortet, und erklären Sie, woher sie stammt.
Preise können aus demselben Grund nützlich sein: Ein Käufer muss wissen, ob eine Option passt. Ein separates Experiment mit sechs Modellen fand in 252 000 Durchläufen starke Präferenzen für Preis und Aktualität, aber jeder Durchlauf bot genau zwei eingeschleuste, anonymisierte Quelldokumente. Das testet die Präferenz bei der ersten Zitierung zwischen kontrollierten Alternativen, nicht, ob eine echte Suchmaschine Ihre Website findet oder zitiert. Veröffentlichen Sie korrekte Preise, wenn Sie können, ohne aus diesem Ergebnis einen versprochenen Zuwachs zu machen.
Lassen Sie die beiden Dinge weg, die nach Aufwand aussehen und keiner sind. Kommerzielle Humanizer-Tools verlieren über 19 getestete Produkte hinweg in 74 % der Fälle einen Vergleich der Sprachflüssigkeit gegen das nicht bearbeitete KI-Original, und sie erfinden dabei halluzinierte Quellenangaben. Und lassen Sie keine „Mach das besser“-Schleife über Ihren eigenen Entwurf laufen, denn LLM-Bewerter belohnen vorhersehbaren Text systematisch zu stark. Jeder Durchgang lässt den Text maschineller klingen, während der Kritiker eine Verbesserung meldet.
Für Bilder gilt dieselbe Trennung. Ein generisches Rendering aus einem Prompt mit drei Wörtern wirkt genauso billig wie ein Artikel aus einem Prompt mit drei Wörtern, und kein Filter und kein Upscaling rettet es. Das Handwerk steckt im Briefing: Nennen Sie Motiv, Licht, Objektiv und Einschränkung, statt Qualitätsadjektive ans Ende zu stapeln. Unsere Leitfäden zu Gemini-Bildprompts und zu ChatGPT-Prompts für beeindruckende Bilder funktionieren beide so, und die Struktur lässt sich zwischen beiden Modellen übertragen.
Eine Variante davon können wir auf unserer eigenen Domain messen. In der Woche bis zum 27. Juli 2026 stellte der Fetcher von ChatGPT 2 370 Anfragen an strataigize.com, gegenüber 1 390 von Googlebot. Beide der bisher einzigen zwei Kunden, die diese Website je gebracht hat, kamen über KI-Antworten, zusammen $215 603 wert. Das geschah auf Seiten mit eigenen Daten, nicht auf Seiten mit cleverem Markup. Wenn es darum geht, ob diese Antworten Ihre Marke nennen, ist das Arbeit für Generative Engine Optimization.
Die Frage war immer, ob jemand beim Lesen etwas lernt, nicht, ob eine Maschine beim Schreiben geholfen hat.
Quellen
- Google Search guidance about AI-generated content
- Google Search Quality Rater Guidelines, 11. September 2025
- Google spam policies
- Google, scaled content abuse and the March 2024 core update
- Google, creating helpful content
- Ahrefs, Google doesn’t punish AI content
- Anthropic, how Claude’s text watermarking works, 14. August 2026
- Anthropic Help Center, how Claude marks AI-generated content
- Google, SynthID verification and partners, 19. Mai 2026
- OpenAI, content provenance documentation
- Semrush, does AI content rank in search
- Liang et al., GPT detectors are biased against non-native English writers, Patterns
- Weber-Wulff et al., Testing of detection tools for AI-generated text
- Sadasivan et al., Can AI-generated text be reliably detected?, TMLR
- Russell, Karpinska & Iyyer, frequent LLM users detect AI text, ACL 2025
- Kobak et al., excess vocabulary in biomedical writing, Science Advances
Sprechen Sie mit uns