¿Google penaliza el contenido de IA? Las fuentes
Google no prohíbe un contenido solo porque la IA ayudó a crearlo. Su guía publicada permite un uso apropiado de la IA y se centra en contenido útil y original, mientras sus políticas de spam prohíben el abuso de contenido a escala. Esa política no revela cada método de detección dentro de Search. Juzgue un artículo por su exactitud, su evidencia y su valor para el lector, en vez de tratar el puntaje de un detector comercial como un veredicto de ranking de Google.
Pregúntele a la mayoría de los marketers si Google penaliza el contenido de IA y obtiene un sí confiado. Pregunte de dónde sale eso y el rastro pasa por posts de blog que citan otros posts de blog, hasta un anuncio de marzo de 2024 que dice lo contrario de lo que le hacen decir.
Fuimos a leer las fuentes primarias. La página de políticas de spam de Google, las 182 páginas de las Search Quality Rater Guidelines, el anuncio sobre abuso de contenido a escala, y la literatura de detección revisada por pares. La respuesta es más clara de lo que sugiere el discurso, y mueve el trabajo a un lugar más útil.
Para llevar
- Las pautas de evaluadores de Google les dicen de forma explícita a los evaluadores humanos que califiquen las páginas sin determinar si intervino la IA. La sección 4.6.5 dice que califiquen el contenido a escala de bajo valor como Lowest «incluso si no está seguro del método de creación».
- La guía publicada de Google sobre contenido de IA permite un uso apropiado. Producir páginas a escala sin agregar valor todavía puede violar sus políticas de spam.
- El 86,5 % de las páginas mejor rankeadas contienen algo de texto generado por IA, y la correlación entre el porcentaje de IA y la posición de ranking es 0,011. Efectivamente cero, en 600 000 páginas.
- Los detectores de IA tampoco pueden resolver la pregunta. Siete de ellos marcaron de forma falsa ensayos de inglés como segunda lengua a una tasa promedio de 61,22 %, y parafrasear baja la detección del 70 % a menos del 5 %.
- Ahora existen marcas de agua de texto. Gemini lleva una desde 2024 y Claude desde el 14 de agosto de 2026. Solo el proveedor que generó el texto puede leer su marca, la verificación de Google Search cubre imágenes, audio y video, y no se ha publicado ningún uso de ranking.
- La barra que de verdad importa es humana. Cinco usuarios frecuentes de grandes modelos de lenguaje (LLM), votando juntos, clasificaron bien 299 de 300 artículos. La pista que nombraron no fue el vocabulario. Fue la originalidad.
Lo que dicen los documentos de Google
Empiece por la evidencia más fuerte, que casi nadie cita: las Search Quality Rater Guidelines. Son las instrucciones que Google da a los humanos que evalúan los resultados de búsqueda. Esos evaluadores tienen mucho más tiempo por página que cualquier rastreador, y se les dice que no se ocupen de determinar el origen.
De la sección 4.6.5 de la edición del 11 de septiembre de 2025:
“Pages and websites made up of content created at scale with no original content or added value for users, should be rated Lowest, no matter how they are created. Even if you are unsure of the method of creation, e.g. whether or not the page is created using generative AI tools, you should still use the Lowest rating when you strongly suspect scaled content abuse.”
La sección 4.6.6 es igual de directa: “the use of Generative AI tools alone does not determine the level of effort or Page Quality rating.”
Eso es una instrucción de evaluación de calidad. Un evaluador puede juzgar contenido a escala de bajo valor sin determinar su origen. No nos dice qué señales internas usan los sistemas automatizados de Google.
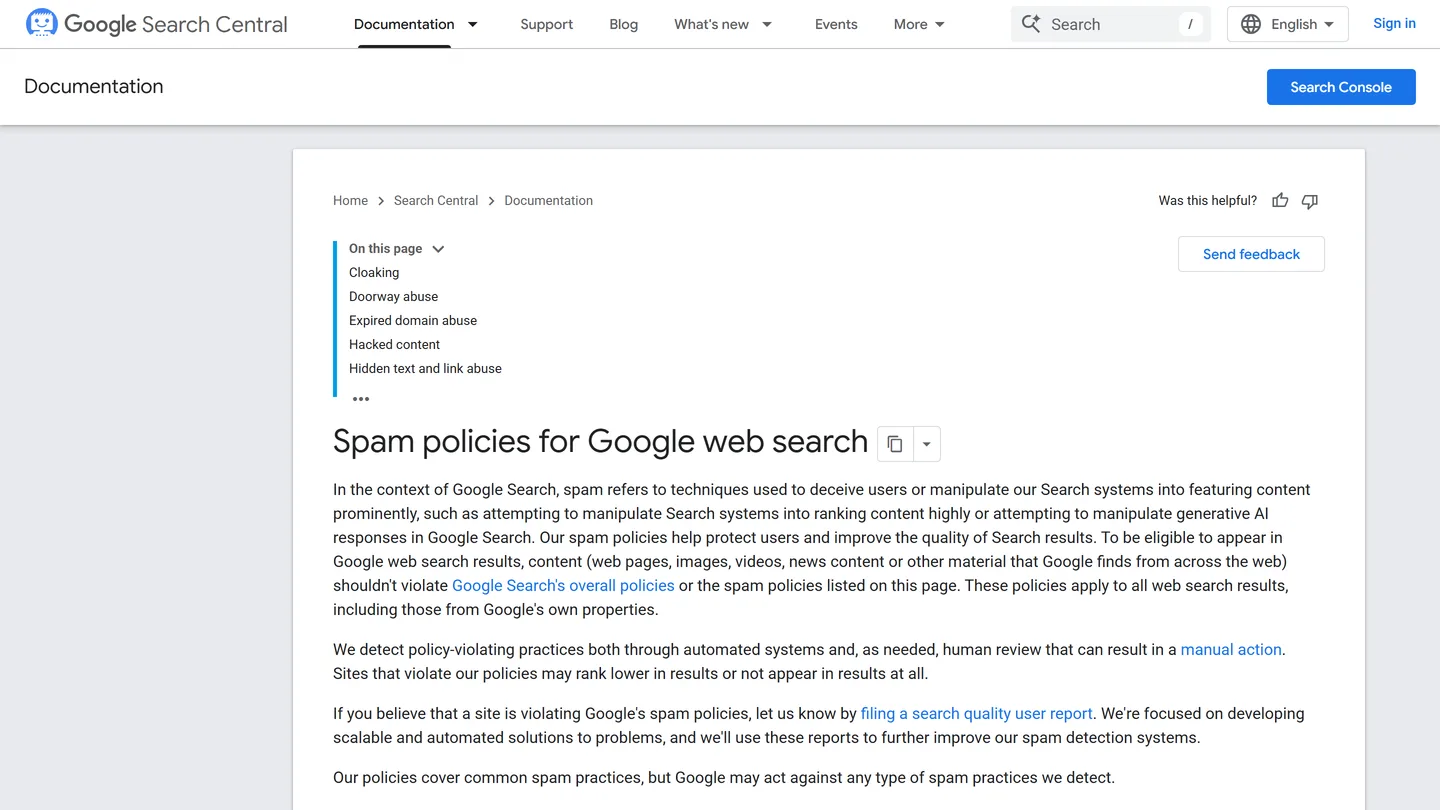
Las políticas de spam de Google tratan el abuso de contenido a escala, el cloaking, las puertas de entrada y otras prácticas manipuladoras. La sección de contenido a escala incluye usar IA generativa para producir muchas páginas sin agregar valor. Su guía de contenido de IA distingue el uso apropiado del contenido generado sobre todo para manipular rankings.
Cada palabra antes de «without adding value» hace menos trabajo del que usted cree. La violación es la escala y el vacío.
Luego está el anuncio de marzo de 2024 en sí, el que suele citarse como la represión de IA. Dice «no matter how it’s created» dos veces. El FAQ de Google en el mismo post explica por qué se reescribió la política:
“It’s been expanded to account for more sophisticated scaled content creation methods where it isn’t always clear whether low quality content was created purely through automation.”
Eso explica por qué la política cubre el abuso sin importar cómo se produjo. No es evidencia de que Google no tenga capacidad de detección, ni de que todo el contenido asistido por IA vaya a rankear.
Los puntajes de los evaluadores de todos modos no tocan los rankings. La documentación de Google sobre contenido útil dice con claridad que «rater data is not used directly in our ranking algorithms.»
Lo que muestran los datos de ranking
Dos estudios grandes, y no coinciden. Ese desacuerdo resulta ser el hallazgo más útil de todo este campo.
| Estudio | Muestra | Resultado |
|---|---|---|
| Ahrefs, julio de 2025 | 600 000 páginas, top 20, 100 000 palabras clave | El 86,5 % de las páginas mejor rankeadas contienen algo de contenido de IA. Correlación entre la parte de IA y la posición: 0,011 |
| Ahrefs, julio de 2026 | 1 000 000 páginas, 100 000 búsquedas | El 5,3 % de los resultados del top 3 son 100 % IA. El puntaje medio de IA solo sube de 27,1 % en la posición 1 a 30,9 % en la posición 10 |
| Semrush, abril de 2026 | 42 000 páginas de blog, GPTZero como detector | La posición 1 es 80,5 % humana, 10 % IA. El contenido humano es «8 veces más probable de rankear» en el n.º 1 |
Elegir un bando es adivinar. Los dos estudios usaron detectores distintos, unidades de medición distintas y corpus distintos. Ahrefs calificó las páginas sobre una base de porcentaje de texto de IA en todos los resultados del top 10. Semrush corrió GPTZero solo sobre páginas de blog y tomó una etiqueta a nivel de documento.
Así que la parte medida de contenido de IA en los resultados de búsqueda es en gran parte una función de qué detector le apunta. Eso es un hecho sobre detectores, no sobre Google.
Ahrefs lo dijo tanto de su propio estudio: «the way we detect AI content will be different from how Google does.» Su conclusión después de un millón de páginas fue más seca. «Google is not against AI content; it is against bad content.»
Por qué los detectores no pueden resolverlo
- Fallan fuerte en el inglés como segunda lengua. Siete detectores probados contra 91 ensayos del examen TOEFL (Test of English as a Foreign Language) produjeron una tasa promedio de falsos positivos de 61,22 %, y los siete clasificaron mal de forma unánime el 19,78 % de ellos. Los mismos detectores fueron casi perfectos en ensayos de octavo grado de EE. UU. Publicado en Patterns por Cell Press.
- Fallan de forma amplia. Una referencia independiente de 14 herramientas encontró que todas marcaron por debajo del 80 % de exactitud, y el texto de IA parafraseado por máquina solo se atrapó el 26 % de las veces.
- Se derrumban ante cambios triviales. Parafrasear bajó un detector de 70,3 % a 4,6 % a una tasa fija de falsos positivos. En una referencia de 6,2 millones de generaciones, dos detectores líderes pasaron de 100 % a casi cero solo al cambiar los ajustes de muestreo del modelo.
- Hay un techo demostrado. Un paper en Transactions on Machine Learning Research (TMLR) deriva un límite duro que vincula la mejor exactitud posible de un detector con cuánto se solapan las distribuciones de texto humano y de máquina. A medida que los modelos mejoran, ese límite se aprieta para todos.
- Los proveedores lo saben. OpenAI retiró su propio clasificador en julio de 2023, publicando una tasa de verdaderos positivos del 26 % y una tasa de falsos positivos del 9 %. El director de producto de Turnitin concedió un «higher false positive rate than the company originally asserted» a los meses del lanzamiento.
Los marcadores lingüísticos en los que se apoyan los detectores se están filtrando a la escritura humana. Un estudio de 737 083 horas de habla de podcasts no guionada en 824 634 episodios (Yakura et al., publicado primero en septiembre de 2024) encontró alzas abruptas posteriores a ChatGPT en exactamente las palabras que los detectores marcan (“delve”, “showcase”, “boast”, “intricacies”, “meticulous”). Un detector que busca “delve” en 2026 está detectando en parte a personas que hablan con chatbots.
Dónde están las marcas de agua de texto en septiembre de 2026
La objeción que está reemplazando «páselo por un detector» es «Google le pone marca de agua», así que aquí está el expediente al 13 de septiembre de 2026.
El SynthID de Google marca el texto de Gemini desde 2024. El 14 de agosto de 2026 Anthropic empezó a incrustar una marca de agua basada en SynthID-Text en la salida de Claude en cada superficie, la API incluida, sin opción de salida, para cumplir el artículo 50 de la ley de IA de la UE. La propia descripción de Anthropic dice que una edición ligera tiende a preservar la marca, que una reescritura completa la quita, y que los pasajes cortos llevan demasiado poco señal para detectarse. OpenAI aplica SynthID a imágenes y audio y no lista ninguna señal para texto.
Tres hechos mantienen esto fuera de la conversación de ranking. Una marca de agua de texto solo se puede leer con la clave que la generó, y el detector de Anthropic es una vista previa privada para reguladores, medios e investigadores. La verificación SynthID en Search y Chrome de Google, anunciada el 19 de mayo de 2026, responde «¿esto lo generó una IA?» para imágenes, audio y video. Y Google no ha publicado nada que ate una marca de agua al ranking; la instrucción a evaluadores citada arriba todavía les dice a sus propios evaluadores que juzguen las páginas «no matter how they are created».
Lo que cambia la era de las marcas de agua es cuánto tiempo el consejo de las dos secciones siguientes sigue siendo cierto. Una página cuya única contribución es la paráfrasis de un modelo eventualmente será identificable como eso, con la cooperación del proveedor, y la ley ahora exige que esa cooperación exista. Una página construida sobre números, pruebas y lectura que ningún modelo produjo conserva su valor, sea cual sea la herramienta que tecleó las oraciones.
Qué de verdad hace que se suprima contenido
Tres cosas. Ninguna es la autoría.
1. Escala sin valor. Los sitios que se desindexaron en 2024 compartían una forma, y es reconocible. Cientos de URL casi idénticas en un solo directorio. Preguntas de Otras preguntas de los usuarios convertidas en encabezados. Fragmentos cosidos que no coheren. Directorios ocultos. Autoría anónima en temas de dinero y de vida. Un caso documentado tenía más o menos cinco millones de URL en un directorio que nadie debía encontrar. Publique contenido escrito por humanos en esa forma y obtiene el mismo resultado.
2. Decaimiento. Un experimento controlado de 16 meses publicó 2 000 artículos de IA sin editar en 20 dominios nuevos, sin enlaces y sin actualizaciones. El 71 % se indexó en 36 días, y la presencia en el top 100 llegó a un pico de alrededor del 28 %. Para el mes tres se había derrumbado al 3 %. Nunca se aplicó una penalización. Las páginas simplemente dejaron de valer la pena de mostrarse.
3. Los lectores. Esta es la barra real y es más alta que cualquier algoritmo. Cinco anotadores que usan LLM con frecuencia, votando como grupo, clasificaron bien 299 de 300 artículos. Se mantuvieron exactos contra la paráfrasis y contra cada herramienta comercial de «humanización» probada. Se les preguntó qué notaron: nombraron formalidad, claridad y originalidad, no palabras.
Eso último es todo el juego, porque la originalidad es una propiedad de la información y no de la prosa. Ninguna indicación, ningún ajuste de muestreo y ninguna pasada de edición crea un hecho que no estuviera ya disponible. Si su comprador lee la pieza y la reconoce como una reformulación competente de los tres primeros resultados, usted perdió en una dimensión que ninguna herramienta mide.
Qué hacer en su lugar
Use la guía publicada de calidad y de spam de Google para decidir qué mejorar. El puntaje de un detector comercial no puede decirle si el artículo responde bien la pregunta del lector.
Ponga en la página algo que no esté ya en la web. Números propietarios de sus propias cuentas. Pruebas de primera mano en las que de verdad corrió la cosa y registró lo que pasó. Una entrevista con la persona que hizo el trabajo. Lectura original de fuentes primarias, que reporta dónde el resumen popular se equivocó. Si una pieza no tiene nada de eso, tiene un techo que ninguna cantidad de pulido levanta.
Haga fácil de comprobar la evidencia. Un estudio observacional de 2026 de 21 143 citas encontró puntajes promedio de influencia de fuente más altos en páginas con estadísticas, definiciones y comparaciones. No probó si agregar esas características causa un aumento de citas. Use una estadística porque responde la pregunta del lector, y explique de dónde salió.
Los precios pueden ser útiles por la misma razón: un comprador necesita saber si una opción cabe. Un experimento separado en seis modelos encontró fuertes preferencias de precio y de recencia en 252 000 ensayos, pero cada ensayo ofreció exactamente dos documentos fuente inyectados y anonimizados. Eso prueba una preferencia de primera cita entre alternativas controladas, no si un motor de búsqueda en producción va a descubrir o citar su sitio. Publique precios exactos cuando pueda, sin convertir ese resultado en un alza prometida.
Salte las dos cosas que se leen como esfuerzo y no lo son. Las herramientas comerciales de «humanización» pierden una comparación de fluidez contra el original de IA sin humanizar el 74 % de las veces en 19 productos probados, y de paso introducen citas alucinadas. Y no corra un bucle de «haz esto mejor» sobre su propio borrador, porque los jueces LLM recompensan de forma sistemática el texto predecible. Cada pasada hace que la escritura suene más a máquina mientras el crítico reporta mejora.
La misma división aplica a las imágenes. Un render genérico a partir de una indicación de tres palabras se lee exactamente tan barato como una indicación de artículo de tres palabras, y ningún filtro ni aumento lo rescata. El oficio está en el brief: nombre el sujeto, la luz, el lente y la restricción en vez de apilar adjetivos de calidad al final. Nuestras guías de indicaciones de imagen de Gemini y indicaciones de ChatGPT para visuales impactantes funcionan las dos así, y la estructura se transfiere entre los dos modelos.
Podemos medir una versión de esto en nuestro propio dominio. En la semana al 27 de julio de 2026, el extractor de ChatGPT hizo 2 370 solicitudes a strataigize.com contra 1 390 de Googlebot. Los dos únicos clientes que este sitio web ha producido jamás llegaron por respuestas de IA, por un valor de 215 603 USD juntos. Eso ocurrió en páginas que llevaban datos originales, no en páginas que llevaban marcado ingenioso. Si la pregunta es si esas respuestas nombran su marca, ese trabajo es la optimización para motores generativos.
La pregunta siempre fue si alguien aprende algo al leerlo, no si una máquina ayudó a escribirlo.
Fuentes
- Guía de Google Search sobre contenido generado por IA
- Search Quality Rater Guidelines de Google, 11 de septiembre de 2025
- Políticas de spam de Google
- Google, abuso de contenido a escala y la actualización central de marzo de 2024
- Google, crear contenido útil
- Ahrefs, Google doesn’t punish AI content
- Anthropic, how Claude’s text watermarking works, 14 de agosto de 2026
- Centro de ayuda de Anthropic, how Claude marks AI-generated content
- Google, verificación SynthID y socios, 19 de mayo de 2026
- OpenAI, documentación de procedencia de contenido
- Semrush, does AI content rank in search
- Liang et al., GPT detectors are biased against non-native English writers, Patterns
- Weber-Wulff et al., Testing of detection tools for AI-generated text
- Sadasivan et al., Can AI-generated text be reliably detected?, TMLR
- Russell, Karpinska e Iyyer, frequent LLM users detect AI text, ACL 2025
- Kobak et al., excess vocabulary in biomedical writing, Science Advances
Hable con nosotros