Qué mide de verdad una evaluación de IA
Un puntaje de benchmark le dice cómo se desempeñó un modelo en un conjunto fijo de preguntas, calificado de una forma particular. No le dice si el modelo funcionará en sus datos. Una reseña de 2025 de 445 benchmarks de modelos de lenguaje encontró que solo el 16% corrió alguna prueba estadística sobre sus resultados, y un trabajo aparte muestra que más o menos la mitad de los modelos testeados ya había visto contenido del benchmark durante el entrenamiento. Antes de comprar un sistema de IA, construya un conjunto pequeño etiquetado a partir de sus propios casos reales y mida contra eso.
Cada deck de un proveedor de IA contiene un gráfico donde su barra es más alta que las otras. El gráfico suele ser exacto. También suele ser irrelevante para la pregunta que el comprador está haciendo de verdad, que es si la cosa funcionará en sus propios documentos, sus propios tickets, sus propias imágenes.
Ese hueco no es deshonestidad de marketing. Es un problema de medición, y se ha documentado con suficiente cuidado como para que usted mismo pueda comprobarlo.
Un benchmark es un instrumento, y los instrumentos necesitan validación
En las ciencias que miden cosas que no se pueden ver de forma directa, un instrumento de medición tiene que ganarse la confianza antes de que sus lecturas signifiquen algo. La propiedad que se mide tiene que estar definida. El test tiene que demostrar que mide esa propiedad y no algo correlacionado con ella. El resultado tiene que venir con alguna estimación de cuánto de él es ruido. La psicometría llama a esto validez de constructo, y es práctica ordinaria.
Los benchmarks de modelos de lenguaje son instrumentos de exactamente este tipo. «Razonamiento» y «utilidad» no son observables de forma directa, así que un benchmark los sustituye. La pregunta de si el sustituto funciona se puede responder, y en 2025 un equipo de 29 reseñadores la respondió a lo largo de 445 benchmarks extraídos de las principales conferencias de procesamiento de lenguaje natural y machine learning, en un trabajo publicado en el track de Datasets and Benchmarks de NeurIPS 2025.
Los números valen leerlos despacio:
- 16.0% condujo alguna prueba estadística o estimación de incertidumbre. El otro 84% reporta un número sin indicación de cuánto se movería si lo corriera otra vez.
- 47.8% de los benchmarks que definieron su objetivo en absoluto estaban midiendo un fenómeno contestado, es decir, algo sobre cuya definición el campo no coincide.
- 81.3% calificó con coincidencia exacta de strings, y el 40.7% no usó nada más. Una respuesta correcta formulada de otra forma cuenta como incorrecta.
- 42.6% reutilizó ítems de benchmarks existentes, que es cómo un defecto en un test se propaga a los tests que se suponía que lo comprobarían.
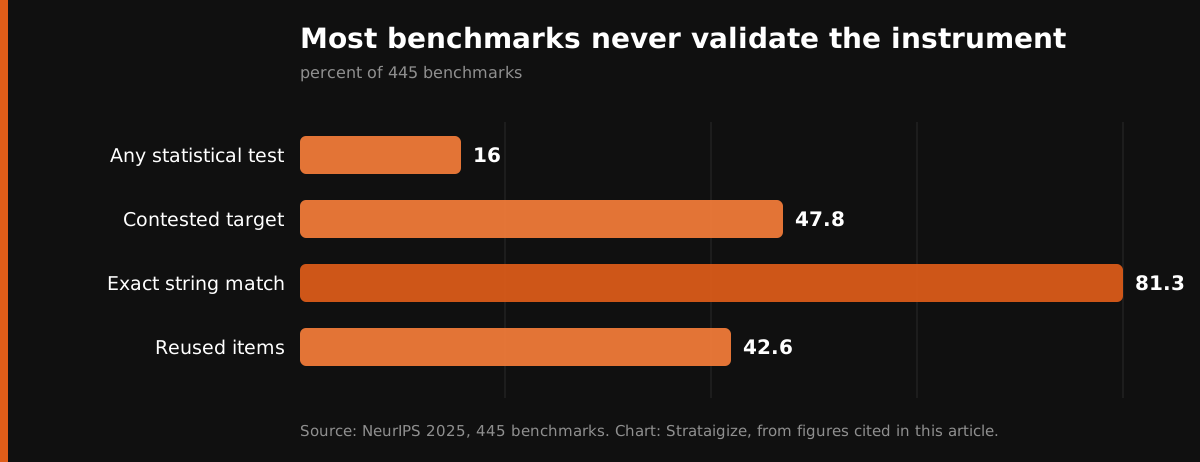
La mayoría de los 445 benchmarks nunca validó el instrumento. Fuente: NeurIPS 2025, Measuring what Matters.
Nada de esto significa que los benchmarks no valgan. Significa que un puntaje de benchmark es una afirmación más débil de lo que parece, y la fuerza de la afirmación rara vez se enuncia junto a él.
El problema de contaminación ablanda el número todavía más
Un benchmark funciona solo si el modelo no ha visto ya las respuestas. Los corpus de entrenamiento modernos son lo bastante grandes, y se scrapean con suficiente amplitud, como para que esto sea difícil de garantizar y fácil de equivocar.
Investigadores de Shanghai Jiao Tong University testearon 31 modelos en busca de evidencia de filtración de benchmarks en GSM8K y MATH, dos conjuntos de datos de razonamiento matemático, usando perplejidad y exactitud de predicción de n-gramas para detectar memorización. Más o menos la mitad mostró señales de haberse entrenado en datos de benchmark. En el caso más claro, Qwen-1.8B reprodujo cada secuencia de cinco palabras en 223 ejemplos del conjunto de entrenamiento de GSM8K, 67 del conjunto de entrenamiento de MATH y 25 del conjunto de test de MATH, la partición cuyo propósito entero es no haber sido vista.
Un modelo que ha memorizado parte de un test va a puntuar bien en él y no le dice nada sobre el desempeño en cualquier otra cosa. Desde afuera, eso se ve idéntico a un modelo que simplemente es bueno.
Cómo se veía esto en la investigación
Mi trabajo doctoral fue lograr que modelos preentrenados hicieran tareas visuales para las que nunca se entrenaron, sin ejemplos etiquetados: encontrar correspondencias semánticas usando un modelo de difusión en NeurIPS 2023, luego keypoints de la misma clase de modelo en la conferencia Computer Vision and Pattern Recognition en 2024. Ambos se midieron contra benchmarks etiquetados estándar, porque así es como el campo compara métodos.
Esos números eran reales y las comparaciones eran justas. Tampoco podían responder la pregunta que haría una empresa, que es si el método funciona en sus imágenes, a su resolución, con su iluminación, bajo su definición de una respuesta correcta. El desempeño en benchmark y el desempeño desplegado son mediciones distintas. Cualquiera que haya movido un modelo de un paper a un producto ha visto el hueco.
La eval que construye usted mismo es la única acotada a su decisión
La solución no es glamurosa y funciona. Antes de comprometerse con un sistema de IA, arme un conjunto de casos reales de su propia operación y etiquete el resultado correcto a mano. Es la media jornada más útil que cualquiera pasa en un proyecto de IA.
Muestree de la realidad, no de los casos fáciles. Extraiga leads reales, tickets reales, facturas reales, fotografías reales, incluidos los malformados. Un conjunto extraído solo de ejemplos limpios mide un sistema que usted no tiene.
Apunte a 100 a 300 ítems etiquetados para empezar. Lo suficiente para separar un sistema que acierta la mayor parte del tiempo de uno que acierta un poco más a menudo que el azar, y lo bastante pequeño para que una persona realmente pueda hacerlo en una tarde.
Anote qué significa correcto antes de mirar cualquier output. Dos personas del mismo equipo con frecuencia no coinciden sobre si un lead estaba calificado o si un documento se archivó bien. Resolver ese desacuerdo en el papel vale la pena hacerlo independientemente de si compra algo, y hacerlo después significa que la definición se dobla para encajar el resultado.
Etiquete los casos ambiguos como ambiguos. Forzar una respuesta binaria sobre un caso que su propio equipo escalaría construye un test que castiga el comportamiento correcto.
Reserve una parte. Mantenga una porción no vista por nadie que construya o afine el sistema, incluido su proveedor. Esa porción reservada es la única parte cuyo puntaje puede tomar al pie de la letra.
Registre la tasa de desacuerdo entre sus propios etiquetadores. Si dos de sus personas coinciden el 85% del tiempo, un sistema que puntúa 85% está desempeñándose a nivel humano en su tarea, y un proveedor que promete 99% o está midiendo otra cosa o ha visto sus respuestas.
Qué preguntarle a un proveedor
Las preguntas útiles son sobre método, no sobre puntaje.
Pregunte sobre qué se midió el número reportado, y si el sistema se afinó en esos mismos datos. Pida el desempeño en los casos que se equivoca, ya que el análisis de errores estuvo en gran medida ausente de los 445 benchmarks reseñados y suele ser donde vive el riesgo operativo. Pregunte cuál sería el número en un conjunto que el proveedor nunca ha visto, y luego suministre uno. Pida un intervalo de confianza, o el resultado de correr la evaluación más de una vez.
Un proveedor que puede responder esto está haciendo el trabajo. Un proveedor que responde solo con una posición en un leaderboard le ha dicho dónde rankea en el test de otra persona.
Cómo lo aplicamos
Cada sistema en nuestro catálogo de sistemas de IA se construye sobre una secuencia fija, y el segundo paso es que un conjunto etiquetado a mano de los casos reales del cliente se acuerda antes de que alguien discuta horas ahorradas. Nada se escala sobre un número de benchmark. La Auditoría de Oportunidad de IA que abre la mayoría de los engagements produce ese conjunto etiquetado como un entregable, y es suyo construyamos o no algo después.
La evaluación también es lo que hace significativo un umbral de corte por escrito. Acordar de antemano pararse en un nivel definido de desempeño es una promesa vacía sin una forma acordada de medir el desempeño.
Fuentes
- Measuring what Matters: Construct Validity in Large Language Model Benchmarks, NeurIPS 2025 Datasets and Benchmarks track: arxiv.org/abs/2511.04703
- Benchmarking Benchmark Leakage in Large Language Models, Xu, Wang, Fan and Liu: arxiv.org/html/2404.18824v1
Hable con nosotros