Come funziona davvero la Generative Engine Optimization
La generative engine optimization migliora l'idoneità e l'utilità di un sito web come fonte per le risposte dell'AI. Il lavoro pratico è accesso dei crawler, risposte chiare sostenute da prove originali, informazioni aziendali coerenti e misurazione ripetuta. Scansione, recupero, fondamento, conferma e attribuzione sono un modello utile per diagnosticare le lacune, non una sequenza universale che ogni motore segue. Voi controllate cosa pubblicate e come risponde il vostro sito. Ogni motore decide cosa recuperare, citare e dire.
Il lavoro di Generative Engine Optimization (GEO) è più facile da valutare quando separate le parti che potete migliorare dalle decisioni che prende un motore. Le cinque fasi qui sotto sono il nostro modello diagnostico. Gli operatori documentano sistemi di recupero diversi e i loro processi interni non sono del tutto pubblici. Usate il modello per trovare prove mancanti o problemi di accesso, non per promettere una citazione.
Cosa decide davvero se venite citati
- Scansione, indicizzazione, citazioni, visite e richieste sono risultati diversi. Un recupero riuscito dimostra l’accesso; non dimostra né la selezione né la domanda.
- I conteggi storici di Cloudflare sul nostro sito mostrano richieste che dichiarano identità di fetcher AI. Quei conteggi richiedono una verifica dell’operatore prima di poter stabilire quali bot abbiano fatto le richieste.
- Il recupero non è il vostro posizionamento. Le analisi di fine 2025 di BrightEdge e Originality.AI collocano la quota di citazioni di AI Overviews provenienti dai primi 10 risultati organici tra circa il 17% e il 52%, quindi essere citati è un risultato separato dall’essere posizionati.
- Pubblicate prove che un acquirente possa verificare: confronti utili, osservazioni originali e fonti per le affermazioni rilevanti. I risultati sperimentali di visibilità non garantiscono un aumento universale delle citazioni.
- Le fonti indipendenti possono aiutare acquirenti e sistemi di ricerca a valutare un’affermazione. Ripetere un’affermazione su più siti non la rende vera.
La pipeline, e dove sono le leve
| Fase | Cosa fa il motore | Cosa controllate | Leva più forte |
|---|---|---|---|
| 1. Scansione | Può recuperare la pagina o usare contenuti indicizzati | La risposta del sito, non i tempi di scansione | Accesso dei crawler, velocità di rendering, HTML statico |
| 2. Recupero | Scompone la domanda in sotto-domande, estrae passaggi candidati | In parte | Copertura del tema, pertinenza dei titoli alla sotto-domanda, freschezza |
| 3. Fondamento | Usa le fonti selezionate per sostenere una risposta | Le prove pubblicate, non la scelta delle fonti | Risposte chiare, contesto, fonti collegate |
| 4. Conferma | Può confrontare un’affermazione con altre prove | Le prove che fornite, non il giudizio del motore | Sostegno indipendente e dati originali |
| 5. Attribuzione | Decide se e come nominare una fonte | Quasi nulla | Chiarezza dell’entità, essere l’origine del dato |
Tutto ciò che segue è un percorso attraverso questa tabella.
Fase 1: la scansione, e i tre bot che non sono lo stesso bot
I crawler di ricerca, i crawler di addestramento e i fetcher su richiesta dell’utente hanno compiti diversi. Bloccare l’accesso diretto può limitare il modo in cui le vostre pagine vengono recuperate, ma un brand può comunque comparire attraverso altre fonti o dati di indice esistenti.
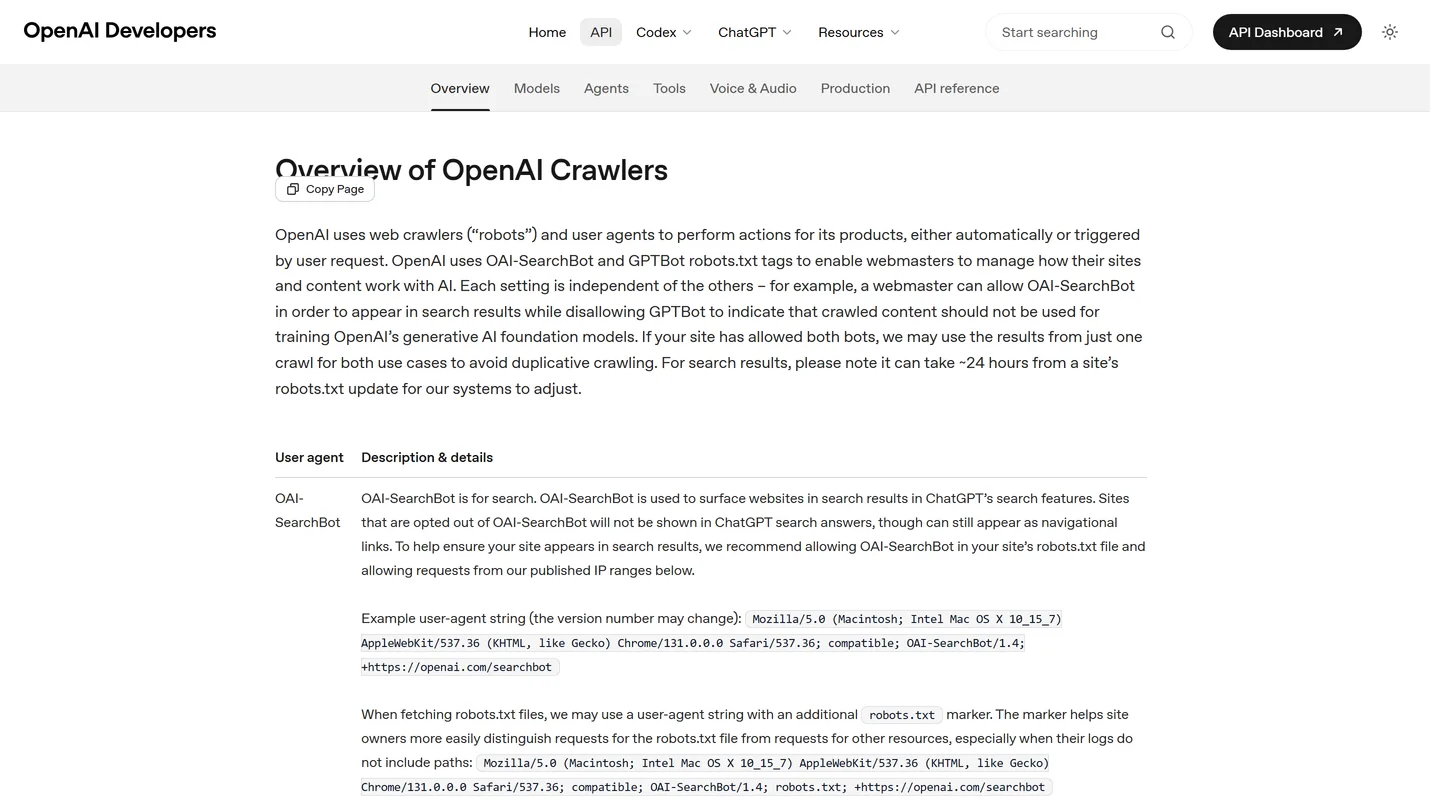
Prendendo come esempio la flotta di OpenAI, documentata nel riferimento sui bot di OpenAI, i ruoli si dividono nettamente:
- GPTBot riguarda i contenuti che possono essere usati per l’addestramento dei modelli. La sua policy robots è indipendente da quella di SearchBot.
- Il crawler di ChatGPT Search supporta ChatGPT Search. Consentirlo, insieme ai suoi indirizzi di rete verificati, supporta l’accesso alla fonte; non garantisce l’inclusione.
- ChatGPT-User recupera contenuti per azioni degli utenti. Una stringa user-agent corrispondente, da sola, non dimostra né l’identità dell’operatore né un visitatore qualificato.
Controllate la documentazione di ogni operatore. PerplexityBot supporta la ricerca; ClaudeBot riguarda l’addestramento, mentre Claude-SearchBot supporta la ricerca. Google-Extended è un token di policy di robots.txt, non un crawler HTTP separato. L’inclusione nella Ricerca Google è un controllo separato.
Il nostro report storico dei log per la settimana fino al 27 luglio 2026 ha contato 2 370 richieste che dichiaravano ChatGPT-User e 1 390 che dichiaravano Googlebot. Quei totali sono stati classificati in base allo user agent. Non possono stabilire un volume verificato di crawler né una domanda umana senza ulteriori prove d’identità. Tenete le richieste dichiarate separate dai bot verificati, dai referral e dai lead.
Ne seguono due controlli. Il testo e i link importanti devono essere disponibili nell’HTML restituito, così il recupero non dipende da un crawler che esegue i vostri script. Google può eseguire il rendering di JavaScript, ma il supporto al rendering varia da sistema a sistema. Confrontate inoltre i log di accesso con gli analytics senza trattarli come la stessa popolazione: il recupero di un bot non è una sessione del browser.
Fase 2: il recupero, ovvero perché il posizionamento ha smesso di prevedere le citazioni
Alcune funzioni di ricerca AI usano il query fan-out: cercano domande correlate per raccogliere fonti per una risposta. Google documenta questo comportamento per le sue funzioni AI. Le query esatte e il processo di recupero variano per prodotto e richiesta, quindi non è una sequenza universale che potete ricostruire da una sola risposta.
È questa scomposizione il motivo per cui posizionamento e citazione si sono separati. Non competete più per una sola query, competete per una raffica di sotto-domande che non vedete mai, e l’insieme dei candidati per ciascuna viene preso più in largo dei primi dieci link. Le misurazioni pubblicate a fine 2025 non concordano sull’entità ma sulla direzione sì: il monitoraggio della sovrapposizione dei ranking di BrightEdge (settembre 2025, 16,7% delle citazioni dai primi 10 risultati) e lo studio sulle citazioni di Originality.AI (novembre 2025, 52%) delimitano la quota di citazioni di AI Overviews provenienti dai primi 10 organici tra circa il 17% e il 52%.
Qui controllate la copertura e la forma, non il fan-out in sé:
- Coprite le domande successive utili. Tenete insieme le informazioni correlate quando questo aiuta il lettore. Pagine separate devono servire esigenze distinte, non limitarsi a puntare su piccole variazioni di query. La guida all’ottimizzazione per l’AI di Google mette in guardia dal generare pagine del genere principalmente per manipolare ranking o risposte dell’AI.
- Usate titoli che descrivano la risposta. Un formato domanda e risposta può aiutare quando i lettori hanno domande specifiche. Non è un formato obbligatorio per l’AI né un motivo per trasformare ogni articolo in una FAQ.
- Restate aggiornati con modifiche reali. In questi sistemi la recenza pesa in modo insolito. Un aggiornamento reale cambia il contenuto; cambiare solo la data non cambia nulla e i motori se ne accorgono sempre di più.
Fase 3: il fondamento, e la scoperta che ha dato il nome al settore
Il fondamento collega una risposta alle prove selezionate. Potete migliorare la chiarezza della pagina e il sostegno a un’affermazione, ma è il motore a decidere quali fonti e passaggi usare.
Lo studio di benchmark sulla GEO (Aggarwal et al., la ACM SIGKDD Conference on Knowledge Discovery and Data Mining del 2024) ha testato nove modifiche ai contenuti su circa 10 000 query. Hanno vinto l’aggiunta di statistiche verificabili, l’inserimento di citazioni credibili e il rimando a fonti affidabili. Migliorare la scorrevolezza ha aiutato meno. Il keyword stuffing ha prodotto effetti trascurabili o negativi.
Attenzione al numero di punta di quello studio, perché viene citato male ovunque, anche dalle agenzie che ci vendono sopra. Il tanto ripetuto “aumento del 40%” è un guadagno relativo su una base del 19,8% in una metrica di conteggio delle parole corretta per posizione, misurato tra cinque fonti già inserite nel contesto del modello. È un risultato di quota di risposta dentro un simulatore, non una misura del fatto che veniate scoperti. Una scoping review di 45 studi pubblicata a luglio 2026 lo dice esplicitamente, e C-SEO Bench (NeurIPS 2025) ha rilevato che la maggior parte di questi metodi è inefficace o addirittura dannosa per il posizionamento, che la SEO tradizionale li supera e che i guadagni si riducono man mano che più persone li adottano.
La lezione pratica è rendere le prove utili e verificabili. Non trasformate il punteggio di visibilità di un benchmark in una previsione per il vostro sito. I suoi modelli, l’insieme di fonti, i prompt e il metodo di punteggio sono diversi dalla ricerca reale di un acquirente.
Tradotto in regole redazionali:
- Rispondete alla domanda con chiarezza. Mettete presto il punto importante e conservate il contesto necessario a interpretarlo. Non esiste una lunghezza obbligatoria della risposta.
- Usate i numeri quando aiutano la decisione. Indicate fonte, periodo, unità e limiti. Non aggiungete statistiche solo per far sembrare autorevole un passaggio.
- Collegate le affermazioni rilevanti alle prove. Le fonti originali permettono ai lettori di verificare un’affermazione e capire se si applica a loro.
- Usate tabelle vere. Le tabelle HTML semantiche di opzioni, costi o benchmark sono dense, univoche e facili da estrarre. I contenuti comparativi vengono recuperati in misura sproporzionata perché il confronto è ciò che chiedono gli acquirenti.
- Adattate la sicurezza alle prove. Scrivete in modo diretto, ma mantenete i limiti che cambierebbero la decisione di un acquirente. Un’affermazione incerta non diventa più forte quando le si toglie la riserva.
Fase 4: la conferma, la fase su cui nessuno lavora
Le prove indipendenti possono rendere un’affermazione più facile da valutare. Questo non significa che ogni motore esegua una fase di conferma separata, né che ripetere un’affermazione in vari listicle la trasformi in un fatto. Cercate una copertura accurata e una partecipazione utile; evitate menzioni fabbricate o affermazioni copiate presentate come prove indipendenti.
Per questo la GEO smette di essere un progetto del sito web. Le superfici che fanno la conferma sono superfici che non possedete:
- Raccolte e liste dei “migliori X”, perché preconfezionano esattamente il confronto che un motore cerca di costruire. Stare nella lista di qualcun altro batte pubblicare la propria.
- Community e forum, fortemente rappresentati sia nei dati di addestramento sia nel recupero in tempo reale. La partecipazione genuina si accumula; lo spam vi fa filtrare.
- Copertura guadagnata e menzioni di terzi, anche senza link. Una menzione senza link insegna comunque al modello un’associazione tra il vostro brand e un tema, e sono le associazioni a essere ricordate.
- Dati originali che altri citano. È la mossa con il ritorno più alto, perché ribalta il rapporto: invece di inseguire le menzioni, pubblicate il numero che tutti gli altri devono citare. Ogni citazione dei vostri dati è una conferma che non avete dovuto negoziare.
Fase 5: l’attribuzione, e perché venite nominati o saltati
L’ultima fase decide se il motore dice “secondo voi” o dice semplicemente la cosa. Qui il vostro controllo è minimo, e due fattori fanno quasi tutto il lavoro.
Chiarezza dell’entità. Il modello deve sapere chi siete con abbastanza sicurezza da nominarvi. Nomi aziendali incoerenti, profili mancanti o contraddittori su LinkedIn, Crunchbase e piattaforme di recensioni, e descrizioni vaghe di ciò che fate rendono tutti l’attribuzione rischiosa, e i motori saltano le attribuzioni rischiose. Sistemare questo è igiene dei dati poco affascinante, ma regge tutto il resto.
Essere l’origine. I motori attribuiscono alla fonte di un dato più volentieri che a un sito che lo ha ripetuto. Se il numero è nato da voi, l’attribuzione segue il numero. Se avete riassunto la ricerca di qualcun altro, la citazione di solito va a loro. È l’argomento più forte che esista a favore dei dati originali, e non è affatto un argomento di GEO: è semplicemente valere la pena di essere citati.
Cosa non potete controllare, e dovreste smettere di provarci
Tre cose sono fuori dalla pipeline che potete influenzare, e fingere il contrario brucia trimestri.
Il fan-out. I motori scelgono le ricerche correlate, e una risposta campione non rivela ogni decisione di recupero. Coprite le esigenze reali dei lettori. Generare lievi varianti di query principalmente per manipolare la visibilità nella ricerca è proprio il problema da cui Google mette in guardia.
La formulazione della risposta. Il modello parafrasa. Potete influenzare ciò su cui si fonda, mai come formula il risultato.
Se l’utente fa clic. Citazione, visita e acquisto sono decisioni separate. Monitorate la visibilità insieme a visite qualificate, richieste e fatturato. Un pannello di prompt è un campione di risposte, non un tasso di conversione né la prova che una modifica specifica abbia prodotto un guadagno.
Cosa ha prodotto la pipeline sul nostro sito
L’abbiamo applicata a strataigize.com prima di venderla a chiunque, ed è l’unico motivo per cui siamo disposti a pubblicare dati specifici.
Un intervento di fine 2025 sul sito precedente, pubblicato il 2025-12-10, ha portato le sessioni attribuite a ChatGPT da 38 a 474 (tasso di coinvolgimento dal 44,7% al 53,8%) e Perplexity da 21 a 76, con 117 citazioni AI in Semrush al 2025-12-09. Sono arrivati lead attribuiti direttamente a entrambi i motori. Le tabelle complete prima e dopo sono nel case study sulla SEO per l’AI. La ricerca AI era un canale emergente quando abbiamo iniziato; il motivo per cui testiamo presto questi canali è in perché testiamo i canali emergenti.
Il quadro dei ricavi, con la sua riserva allegata: entrambi gli unici due clienti che il nostro sito abbia mai prodotto sono arrivati tramite risposte dell’AI, per un valore complessivo di $215 603, ovvero il 29,7% del nostro fatturato chiuso totale. Circa il 95% di quella cifra è un singolo contratto. Questo dimostra che il canale chiude alle nostre dimensioni di contratto e non dimostra nulla su un tasso. Teniamo la riserva allegata perché un numero così buono è esattamente il tipo che viene usato male.
Un tranello strutturale da copiare: il contratto più grande era etichettato “Organic Search” nel nostro CRM, ed è stato il cliente a indicare il percorso assistito dall’AI. Google ora documenta un rapporto sul rendimento dell’AI generativa separato per le impressioni di AI Overviews e AI Mode. Quelle impressioni non identificano quale lead abbia fatto clic su una risposta dell’AI. Tenete i rapporti di visibilità proprietari e il racconto dell’acquirente su come vi ha trovati come prove separate.
Lo strato leggibile dagli agenti, per come funziona davvero
Gestiamo anche un server pubblico Model Context Protocol (MCP) su mcp.strataigize.com, un endpoint agent-to-agent, e abbiamo pubblicato delle Agent Skills. Gli agenti possono leggere i contenuti che pubblichiamo attualmente e scoprire il flusso di richiesta di consulenza. Questo rende il sito più facile da usare tramite quelle interfacce; non crea un vantaggio nella ricerca.
Ciò che oggi non è, è una leva per le citazioni. Endpoint leggibili dalle macchine e manifest per agenti non hanno alcun effetto dimostrato sul fatto che ChatGPT vi nomini in una risposta, e non fingeremo il contrario finché mancano le prove. Costruite prima le cinque fasi sopra. Considerate lo strato per agenti come posizionamento e preparazione al futuro.
Dove andare dopo
- Iniziate da qui se il problema sono i termini: answer engine optimization (AEO), GEO e SEO a confronto.
- L’introduzione in parole semplici: cos’è la generative engine optimization.
- Acquistare invece di costruire: cosa includono i servizi di SEO per l’AI e come valutare un’agenzia.
- Gli strumenti per ogni fase: i migliori strumenti di SEO per l’AI.
- Scoprite dove vi trovate oggi: il verificatore di visibilità AI o il nostro servizio gestito di generative engine optimization.
Domande frequenti
Devo bloccare i crawler AI? Decidete separatamente per ricerca, addestramento e recupero su richiesta dell’utente. Bloccare un crawler di ricerca può limitare l’accesso diretto ai vostri contenuti; non cancella ogni menzione del vostro brand. Verificate l’identità dell’operatore e le policy robots e firewall effettive prima di cambiare l’accesso. Per Google, controllate anche l’impostazione di inclusione nell’AI generativa della Ricerca della proprietà.
llms.txt mi aiuta a essere citato? Non ci sono prove che lo faccia. Pubblicarlo non costa quasi nulla ed è un’igiene ragionevole per chi usa agenti, ma diffidate di qualsiasi agenzia che lo venda come strategia di citazione. Le leve sono contenuti, conferma e chiarezza dell’entità.
Ogni quanto i motori AI ricontrollano una pagina? Non esiste un calendario universale. Indicizzazione di ricerca, contenuti in cache e recupero su richiesta dell’utente seguono percorsi diversi. Usate log verificati e i rapporti dell’operatore per vedere cosa è successo sul vostro sito. Aggiornate i fatti rilevanti quando cambiano, invece di cambiare le date per suggerire freschezza.
Perché compaio in un motore e non in un altro? I motori usano sistemi di recupero, impostazioni di prodotto e selezioni di fonti diversi. I risultati possono variare anche per prompt, momento, luogo e contesto dell’utente. Registrate queste condizioni e ripetete le misurazioni prima di considerare una citazione mancante un difetto del sito.
Cambia qualcosa per il B2B? Valgono gli stessi controlli su accesso e prove, ma le esigenze d’acquisto variano. Per i lettori B2B, pubblicate le informazioni di cui hanno bisogno per valutare un fornitore: ambito, prove, contesto dei prezzi, requisiti di implementazione e un passo successivo utile. Misurate le richieste qualificate oltre alla visibilità.
Parla con noi