生成式引擎优化实际如何运作
生成式引擎优化提升网站作为 AI 回答来源的资格与有用性。实务工作是爬虫访问、有原创证据支撑的清晰回答、一致的企业信息,以及反复测量。抓取、检索、锚定、佐证与归因是诊断缺口的有用模型,不是每个引擎都遵循的通用序列。你控制发布什么以及站点如何响应。每个引擎决定检索、引用与说什么。
生成式引擎优化(GEO)工作更好评估的方式,是把你能改进的部分与引擎做的决策分开。下面五步是我们的诊断模型。运营商记录不同的检索系统,且其内部流程并不完全公开。用模型找缺失证据或访问问题,而不是承诺一次引用。
真正决定你是否被引用的是什么
- 抓取、索引、引用、访问与询盘是不同结果。一次成功的抓取证明访问;它不证明选择或需求。
- 我们站点上的历史 Cloudflare 计数显示声称 AI 抓取器身份的请求。这些计数需要运营商验证,才能确立是哪些机器人发出了请求。
- 检索不是你的排名。BrightEdge 与 Originality.AI 在 2025 年末的分析,把来自自然前 10 的 AI Overview 引用份额放在大约 17% 到 52% 之间,因此被引用是与被排名分开的结果。
- 发布买家能核对的证据:有用比较、原创观察,以及实质主张的来源。实验性可见度结果不提供通用引用提升。
- 独立来源可帮助买家与搜索系统评估主张。在多个站点重复断言并不能让它变真。
管道,以及杠杆在何处
| 阶段 | 引擎做什么 | 你控制什么 | 最强杠杆 |
|---|---|---|---|
| 1. 抓取 | 可能抓取你的页面或使用已索引内容 | 站点响应,不是抓取时机 | 爬虫访问、渲染速度、静态 HTML |
| 2. 检索 | 把问题拆成子问题,拉取候选段落 | 部分 | 主题覆盖、标题与子问题的相关性、新鲜度 |
| 3. 锚定 | 用选定来源支撑回答 | 已发布证据,不是来源选择 | 清晰回答、语境、链接来源 |
| 4. 佐证 | 可能把主张与其他证据比较 | 你提供的证据,不是引擎的判断 | 独立支持与原创数据 |
| 5. 归因 | 决定是否以及如何点名来源 | 几乎不 | 实体清晰度、成为事实的起源 |
下面是在这张表上走一遍。
阶段 1:抓取,以及三种不是同一种机器人的机器人
搜索爬虫、训练爬虫与用户请求的抓取器工作不同。阻止直接访问可能限制页面被检索的方式,但品牌仍可能通过其他来源或已有索引数据出现。
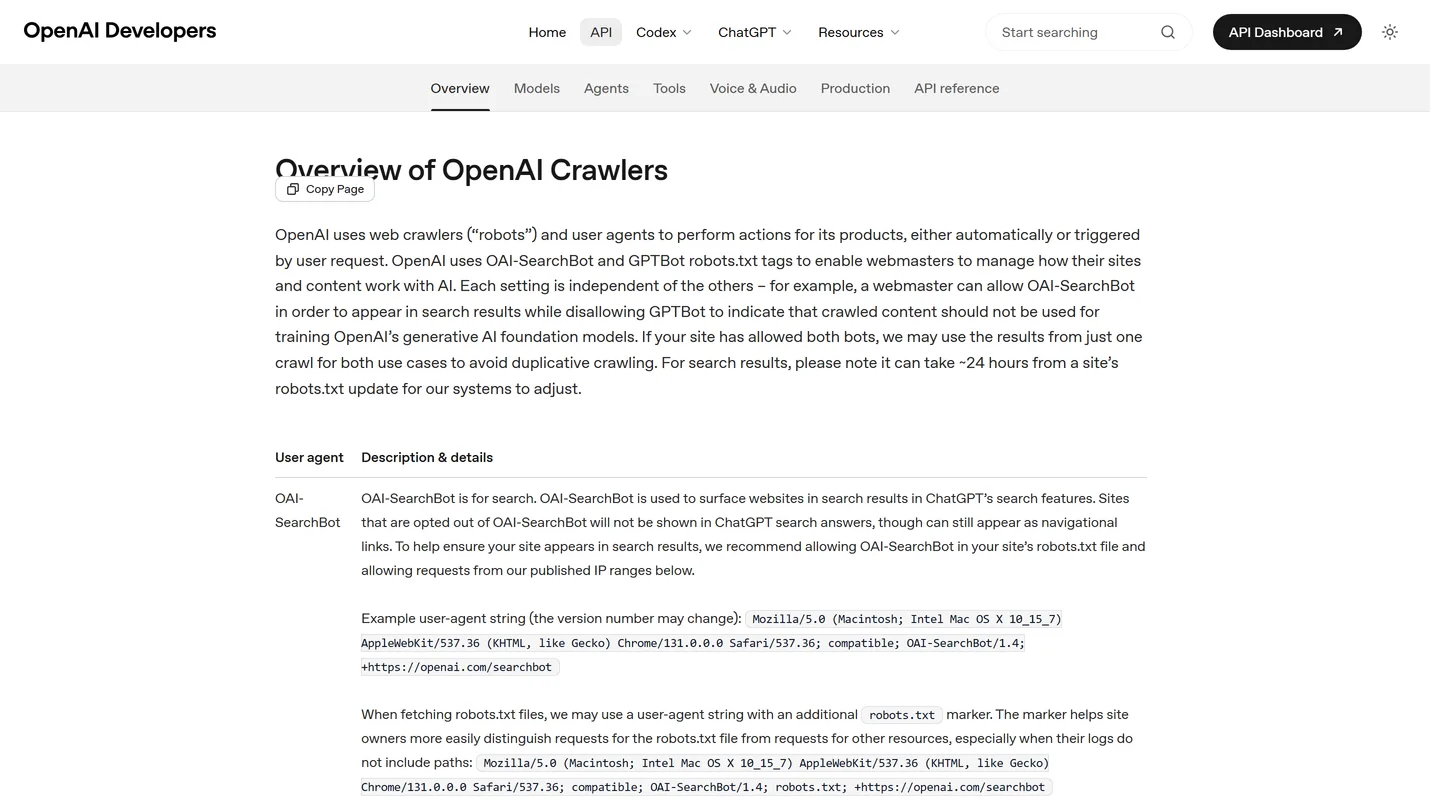
以 OpenAI 的机队为例,记录在 OpenAI 的机器人参考 中,角色分得很清楚:
- GPTBot 关乎可能用于模型训练的内容。其 robots 政策独立于 SearchBot。
- ChatGPT 搜索机器人 支撑 ChatGPT 搜索。允许它及其已验证网络地址,支撑来源访问;这不保证收录。
- ChatGPT-User 为用户动作抓取内容。仅匹配的用户代理字符串,既不证明运营商身份,也不证明合格访客。
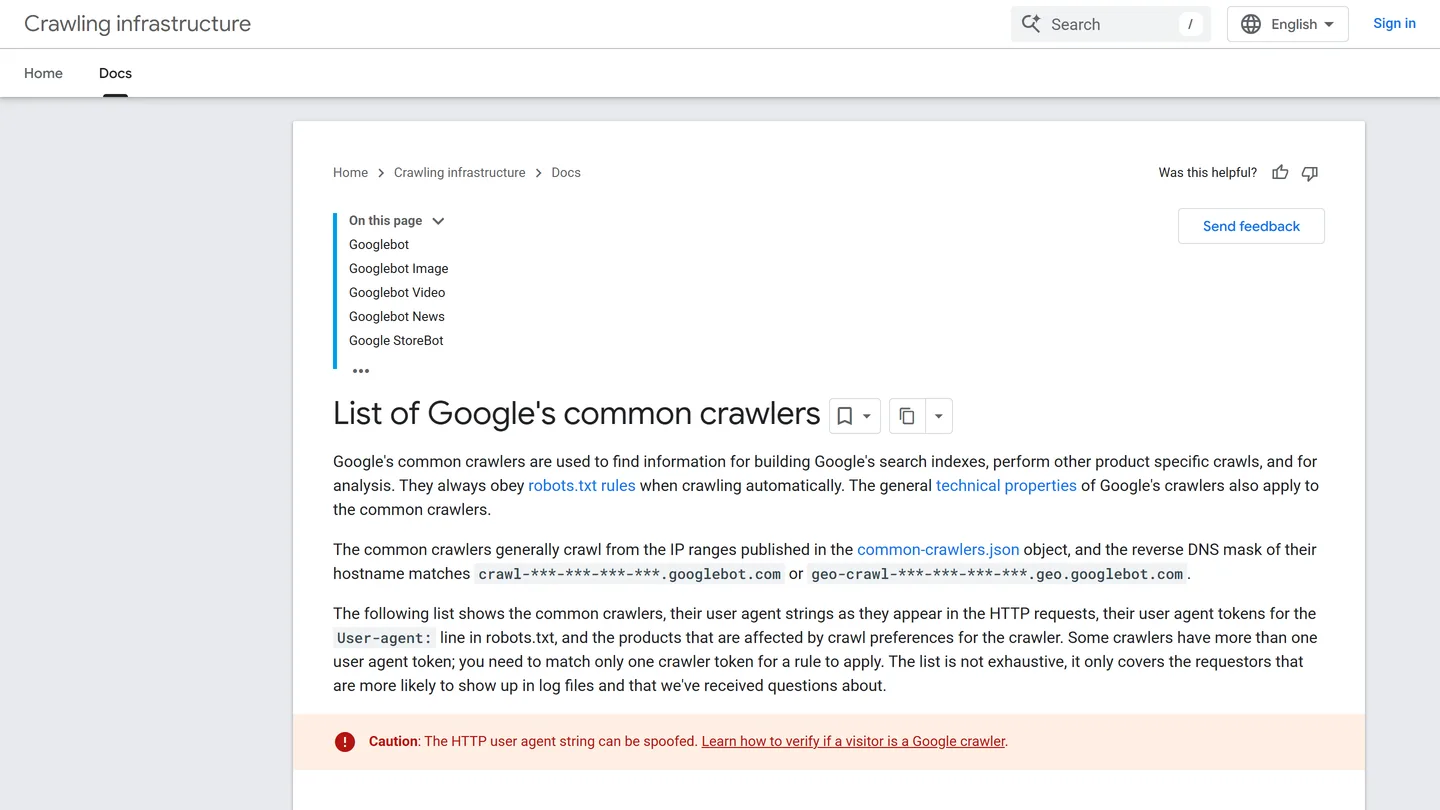
核对每个运营商的文档。PerplexityBot 支撑搜索;ClaudeBot 关乎训练,而 Claude-SearchBot 支撑搜索。Google-Extended 是 robots.txt 政策令牌,不是独立的 HTTP 机器人。纳入 Google 搜索是单独的控制。
我们截至 2026 年 7 月 27 日那一周的历史日志报告,计数为 2,370 次自称 ChatGPT-User 的请求与 1,390 次自称 Googlebot 的请求。这些合计按用户代理分类。在没有进一步身份证据的情况下,它们无法确立已验证机器人量或人类需求。把声明的请求与已验证机器人、引荐与线索分开。
两项控制随之而来。重要文本与链接应在返回的 HTML 中可用,使检索不依赖机器人执行你的脚本。Google 可以渲染 JavaScript,但渲染支持因系统而异。也把访问日志与分析对照,但不要把它们当同一人群:机器人抓取不是浏览器会话。
阶段 2:检索,或为何你的排名不再预测引用
某些 AI 搜索功能使用查询“扇出”:它们搜索相关问题,以为回答收集来源。Google 为其 AI 功能记录了该行为。确切查询与检索过程因产品与请求而异,因此这不是你能从一次回答逆向工程的通用序列。
这种分解解释了为何排名与引用已分离。你不再只为单一查询竞争,你为你从未看见的一束子问题竞争,且每一束的候选集抽取得比前十个链接更广。2025 年末发布的测量在幅度上不一致,但在方向上一致:BrightEdge 的排名重叠跟踪(2025 年 9 月,16.7% 的引用出自前 10)与 Originality.AI 的引用研究(2025 年 11 月,52%)把来自自然前 10 的 AI Overview 引用份额框在大约 17% 到 52% 之间。
你在这里控制的是覆盖与形状,不是扇出本身:
- 覆盖有用的后续问题。 在帮助读者时把相关信息放在一起。分开的页面应服务不同需求,而不只是瞄准细小查询变体。Google 的 AI 优化指南 警告不要主要为操纵排名或 AI 回答而产出此类页面。
- 用描述回答的标题。 当读者有精确问题时,问答格式可能有帮助。它不是要求的 AI 格式,也不是把每篇文章变成 FAQ 的理由。
- 用真更新保持新鲜。 时效在这些系统中权重异常。真更新改变内容;改日期什么也不改变,且引擎越来越能看见这一点。
阶段 3:锚定,以及给这门领域命名的发现
锚定把回答连到选定证据。你可以改进页面清晰度与主张的支撑,但引擎控制它使用哪些来源与段落。
GEO 基线研究(Aggarwal 等,2024 年 ACM SIGKDD 知识发现与数据挖掘会议)在约 10,000 个查询上测试了九种内容修改。赢家是加入可核验统计、嵌入可信引用,以及指向可靠来源。改进流畅性帮助较少。关键词堆砌产生可忽略或负面效应。
警惕该文的标题数字,因为它到处被误引,包括卖对抗它的机构。“40% 提升”常被复述,其实是在 已注入模型上下文的五个来源 中,对按位置调整的词数指标、在 19.8% 基数上的相对增益。那是模拟器里的回答份额结果,不是你是否被发现的测量。2026 年 7 月发表的一项 45 项研究的范围综述 直接这么说,且 C-SEO Bench(NeurIPS 2025)发现这些方法多数无效或主动负面,传统 SEO 胜过它们,且随着更多人采用,增益在收窄。
实务教训是让证据有用且可核验。不要把基准的可见度分数变成对你站点的预测。其模型、来源集、提示与打分方法都与买家的实时搜索不同。
译成编辑规则:
- 清晰回答问题。 早点放上要点,并保留解释所需的语境。没有要求的回答长度。
- 在帮助决策时用数字。 给出来源、时段、单位与限制。不要仅为让段落显得权威而加统计。
- 把实质主张连到证据。 原始来源让读者核验主张,并判断是否适用于他们。
- 用真表格。 选项、成本或基准的语义 HTML 表格密集、无歧义且易抽取。比较内容被不成比例地检索,因为比较正是买家在问的。
- 让确定度对齐证据。 写得直接,但保留会改变买家决策的限定。不确定的主张不会因为去掉保留而变强。
阶段 4:佐证,没人在做的那一步
独立证据可让主张更易评估。这并不意味着每个引擎都跑单独的佐证步骤,也不意味着在列表文中重复主张就让它成为事实。寻找准确覆盖与有用参与;避免捏造提及或把复制断言包装成独立证据。
这就是为何 GEO 不再是网站项目。做佐证的表面是你不拥有的表面:
- 评测与“最佳 X”列表,因为它们预包装了引擎正试图构建的比较。进别人的名单胜过发布你自己的。
- 社区与论坛,在训练数据与实时检索中都高权重。真实参与会累加;垃圾会让你被过滤。
- 赢得的覆盖与第三方提及,包括无链接提及。无链接提及仍教模型你的品牌与主题之间的关联,而关联正是会被回忆起的东西。
- 别人会引用的原创数据。 这是回报最高的动作,因为它反转关系:你不是追提及,而是发布人人必须引用的数字。对你数据的每一次引用,都是一次你不必谈判的佐证事件。
阶段 5:归因,以及为何点名你或跳过你
最后一步决定引擎是说“据你所说”还是只说那件事。你在这里控制最少,且两个因素干了大部分活。
实体清晰度。 模型需要足够自信地知道你是谁才能点名你。不一致的公司名,LinkedIn、Crunchbase 与评论平台上缺失或矛盾的资料,以及对你做什么的模糊描述,都让归因变得冒险,而引擎会跳过冒险的归因。修好这些是不怎么光鲜的数据卫生,且它有载荷。
成为起源。 引擎更愿把归因给事实来源,而不是复述它的站点。若数字从你出发,归因跟着数字走。若你总结了别人的研究,引用通常去向他们。这是存在的、支持原创数据的最强论据,且它根本不是 GEO 论据,只是值得被引用。
你控制不了、且应停止尝试的
三件事在你能影响的管道之外,假装相反会烧掉几个季度。
扇出。 引擎选择相关搜索,且一次采样回答并不暴露每次检索决策。覆盖真实读者需求。主要为操纵搜索可见度而产出轻微查询变体,正是 Google 警告的问题。
回答措辞。 模型会改写。你可以影响它锚定什么,永远不能影响它如何表述结果。
用户是否点击。 引用、访问与购买是分开的决策。把可见度与合格访问、询盘与收入并行跟踪。提示面板是回答样本,不是转化率,也不是某次精确润色造成增益的证据。
管道在我们自己站点上产出了什么
我们在卖给任何人之前先在 strataigize.com 上跑了它,这是我们愿意公布精度的唯一原因。
2025 年末对前一版站点的一次推动,于 2025 年 12 月 10 日发布,把 ChatGPT 归因会话从 38 推到 474(参与率从 44.7% 到 53.8%),Perplexity 从 21 到 76,截至 2025 年 12 月 9 日有 117 条 Semrush AI 引用。有线索被直接归因到两个引擎。完整前后表在 AI SEO 案例 中。我们开始时 AI 搜索还是新兴渠道;我们为何早测,见 为何我们测试新兴渠道。
收入画像,连同附着的限定一起陈述:我们网站有史以来仅有的两个客户都通过 AI 回答到来,合计价值 215,603 美元,占我们终身赢单收入的 29.7%。其中约 95% 是一笔交易。这证明渠道在我们的交易规模上能成交,对任何比率什么也不证明。我们保留附着的限定,因为这么好看的数字正是会被挪用的那种。
一个值得偷走的结构性陷阱:最大那笔交易在我们的 CRM 里标成 “Organic Search”,客户指认了 AI 辅助路径。Google 现已记录独立的 生成式 AI 效果报告,用于 AI Overview 与 AI 模式的展示。这些展示并不识别哪条线索点击了 AI 回答。把第一方可见度报告与买家如何找到你的叙述,当作分开的证据。
agent 可读层,实际如何运作
我们也在 mcp.strataigize.com 跑公共 Model Context Protocol(MCP,模型上下文协议)服务器,一个 agent 到 agent 的端点,以及已发布的 agent 技能。agent 可以读我们当前已发布内容,并发现咨询请求流。这让站点更易被这些界面使用;它并不确立搜索优势。
今天它不是什么:引用杠杆。机器可读端点与 agent 清单对 ChatGPT 是否在回答中点名你没有已证明的效应,在证据缺席前我们不会假装相反。先建上面五步。把 agent 层当定位与预置。
接下来去哪
- 若术语是问题,从这里开始:回答引擎优化(AEO)对 GEO 对 SEO 解释。
- 白话介绍:什么是生成式引擎优化。
- 买而不是建:AI SEO 服务包含什么以及如何评判机构。
- 每步的工具:最佳 AI SEO 工具。
- 看你现在在哪:AI 可见度检查器,或我们托管的 生成式引擎优化服务。
常见问题
我该屏蔽 AI 机器人吗? 对搜索、训练与用户请求的抓取分别决定。屏蔽搜索机器人可能限制对你内容的直接访问;它不会抹掉品牌的每一处提及。在改变访问前,核运营商身份以及生效的 robots 与防火墙政策。对 Google,也核对该资源的 生成式 AI 收录设置。
llms.txt 能帮我被引用吗? 没有证据显示会。发布它几乎零成本,对 agent 消费者是合理卫生,但把任何把它当引用策略卖的机构视为可疑。杠杆是内容、佐证与实体清晰度。
AI 引擎多久会再检查一页? 没有通用时间表。搜索索引、缓存内容与用户请求的抓取走不同路径。用已验证日志与运营商报告看你站点上发生了什么。在事实改变时更新实质事实,而不是改日期来暗示新鲜。
为什么我在一个引擎出现、在另一个不出现? 引擎使用不同的检索系统、产品设置与来源选择。结果也可能因提示、时刻、地点与用户语境而变。记下这些条件并重复测量,再把缺失引用当站点缺陷。
B2B 不一样吗? 同样的访问与证据控制适用,但购买需求不同。对 B2B 读者,发布他们评估供应商所需的信息:范围、证据、价格语境、实施要求与有用的下一步。像测量可见度一样测量合格询盘。
联系我们