生成エンジン最適化(GEO)は実際にどう機能するのか
生成エンジン最適化(GEO)は、AIの回答の情報源としてのウェブサイトの適格性と有用性を高めるものです。実際の作業は、クローラーのアクセス、独自の根拠に裏づけられた明確な回答、一貫した事業情報、そして繰り返しの計測です。クロール、取得、根拠づけ、裏づけ、帰属は、課題を診断するための有用なモデルであり、すべてのエンジンが従う普遍的な手順ではありません。あなたが制御できるのは、何を公開するかとサイトがどう応答するかです。何を取得し、引用し、述べるかは各エンジンが決めます。
生成エンジン最適化(GEO)の取り組みは、自分で改善できる部分とエンジンが下す判断を分けて考えると評価しやすくなります。以下の5段階は、私たちの診断モデルです。事業者ごとに文書化している取得の仕組みは異なり、その内部の処理はすべて公開されているわけではありません。このモデルは、足りない根拠やアクセスの問題を見つけるために使うもので、引用を約束するためのものではありません。
引用されるかどうかを実際に決めるもの
- クロール、インデックス登録、引用、訪問、問い合わせは、それぞれ別の成果です。取得に成功してもアクセスの証明にはなりますが、選ばれたことや需要の証明にはなりません。
- 当社サイトの過去のCloudflareの集計には、AIのフェッチャーを名乗るリクエストが含まれています。どのボットがリクエストしたかを確定するには、事業者による検証が必要です。
- 取得はあなたの順位ではありません。BrightEdgeとOriginality.AIによる2025年後半の分析では、AI Overviewsの引用のうちオーガニック検索の上位10件から来たものの割合は約17%から52%でした。つまり、引用されることと上位表示されることは別の成果です。
- 購入者が確認できる根拠を公開してください。役に立つ比較、独自の観察、重要な主張の出典です。実験的な可視性の結果が、引用の普遍的な増加をもたらすわけではありません。
- 独立した情報源は、購入者や検索システムが主張を評価する助けになります。同じ主張を複数のサイトで繰り返しても、それが真実になるわけではありません。
パイプラインと、決め手がある場所
| 段階 | エンジンがすること | あなたが制御できること | 最も強い決め手 |
|---|---|---|---|
| 1. クロール | ページを取得するか、インデックス済みのコンテンツを使う | サイトの応答(クロールのタイミングは不可) | クローラーのアクセス、描画速度、静的HTML |
| 2. 取得 | 質問を小さな質問に分解し、候補となる文章を集める | 一部 | テーマの網羅性、見出しと小さな質問との関連性、新しさ |
| 3. 根拠づけ | 選んだ情報源で回答を裏づける | 公開した根拠(情報源の選択は不可) | 明確な回答、文脈、リンクした出典 |
| 4. 裏づけ | 主張をほかの根拠と照らし合わせることがある | 提供する根拠(エンジンの判断は不可) | 独立した裏づけと独自データ |
| 5. 帰属 | 情報源を名指しするか、どう名指しするかを決める | ほぼ不可 | エンティティの明確さ、事実の出どころであること |
以下はすべて、この表を順にたどる内容です。
段階1:クロール、そして同じボットではない3つのボット
検索用クローラー、学習用クローラー、ユーザーの要求で取得するフェッチャーは、それぞれ役割が違います。直接のアクセスをブロックするとページの取得のされ方を制限できますが、ブランドはほかの情報源や既存のインデックスデータを通じて表示されることがあります。
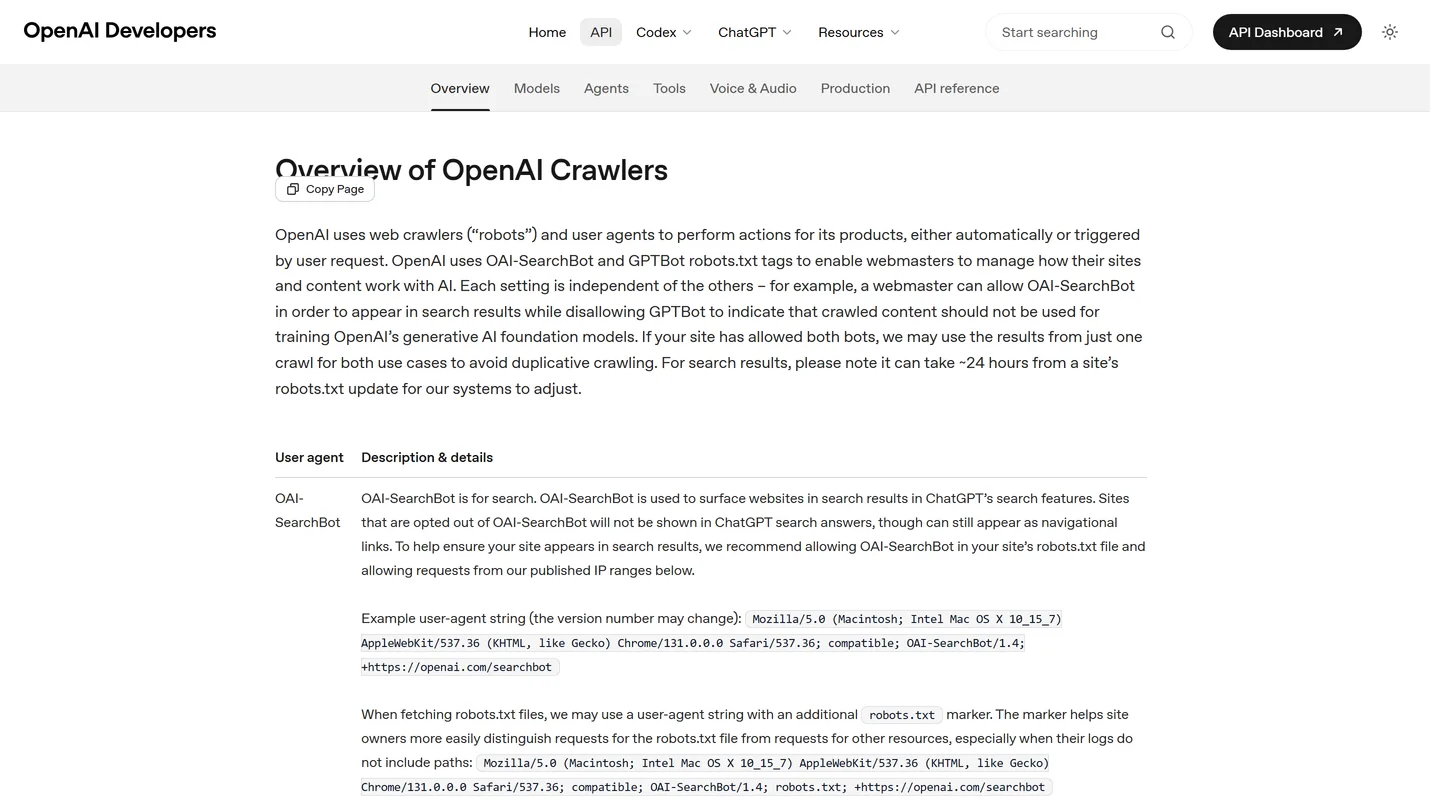
OpenAIのボットのリファレンスに記載されたOpenAIのボット群を例にとると、役割ははっきり分かれています。
- GPTBotは、モデルの学習に使われる可能性のあるコンテンツに関わります。そのrobotsのポリシーはSearchBotとは独立しています。
- ChatGPT SearchのクローラーはChatGPT Searchを支えます。このクローラーと検証済みのネットワークアドレスを許可すると情報源へのアクセスを支えられますが、掲載が保証されるわけではありません。
- ChatGPT-Userは、ユーザーの操作のためにコンテンツを取得します。一致するユーザーエージェント文字列だけでは、事業者の身元も、見込みのある訪問者であることも証明できません。
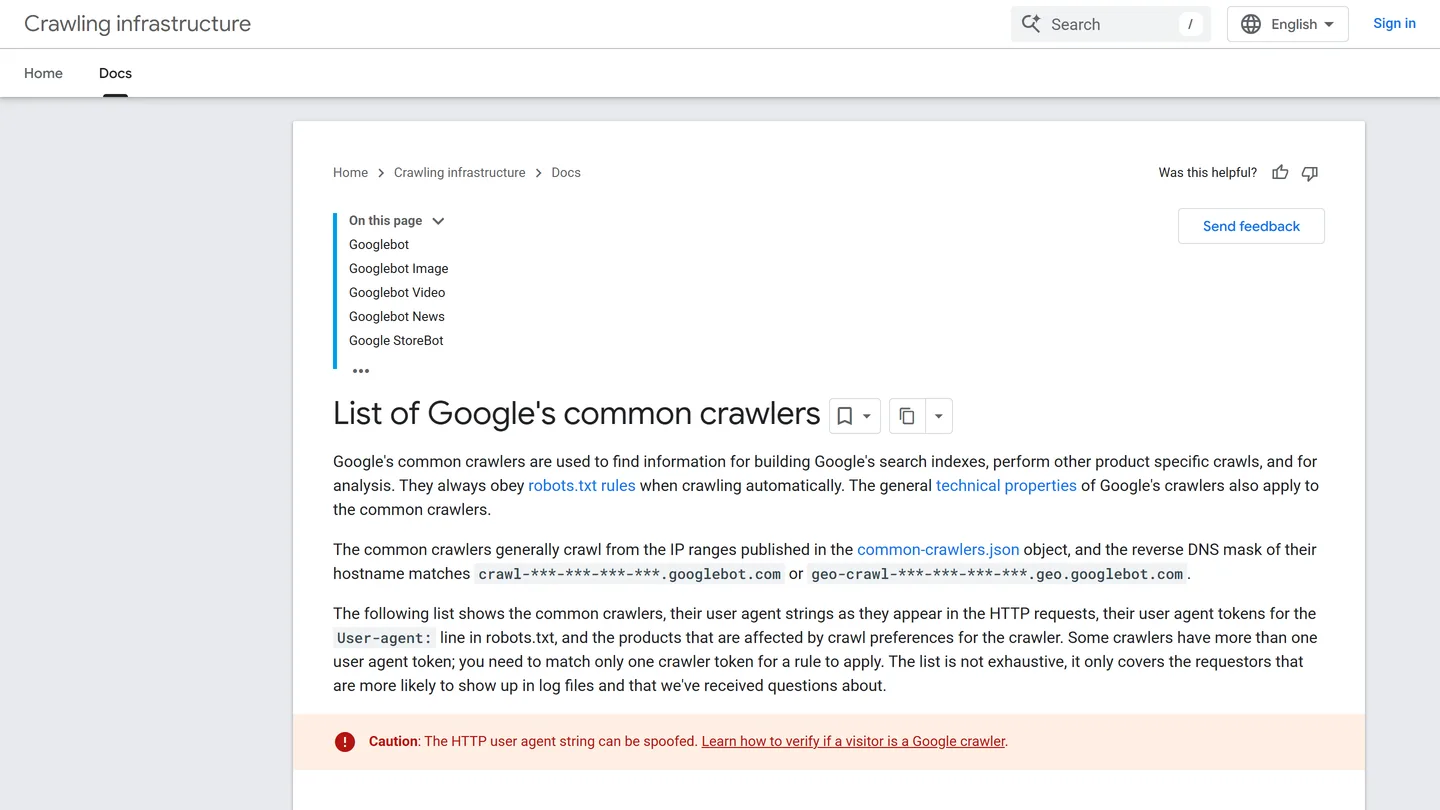
各事業者のドキュメントを確認してください。PerplexityBotは検索を支えます。ClaudeBotは学習に関わり、Claude-SearchBotは検索を支えます。Google-Extendedはrobots.txtのポリシートークンであり、独立したHTTPクローラーではありません。Google検索への掲載は別の設定です。
2026年7月27日までの1週間の過去のログレポートでは、ChatGPT-Userを名乗るリクエストが2,370件、Googlebotを名乗るリクエストが1,390件でした。これらの合計はユーザーエージェントで分類したものです。追加の身元の証拠がなければ、検証済みのクローラーの量も人間の需要も確定できません。名乗っているだけのリクエストは、検証済みのボット、参照元、リードとは分けて扱ってください。
ここから2つの確認事項が出てきます。重要なテキストとリンクは返されるHTMLに含めておき、取得がクローラーによるスクリプトの実行に依存しないようにします。GoogleはJavaScriptを描画できますが、描画への対応はシステムによって異なります。また、アクセスログとアナリティクスを比べる際は、同じ母集団として扱わないでください。ボットによる取得はブラウザのセッションではありません。
段階2:取得、つまり順位が引用を予測しなくなった理由
AI検索機能の中には、クエリファンアウトを使うものがあります。回答の情報源を集めるために関連する質問を検索するのです。Googleは自社のAI機能についてこの挙動を文書化しています。正確なクエリと取得の処理は製品やリクエストによって異なるため、1つの回答から逆算できる普遍的な手順ではありません。
この分解こそ、順位と引用が切り離された理由です。あなたはもう1つのクエリを争っているのではなく、目に見えない小さな質問の群れを争っており、それぞれの候補は上位10件のリンクよりも広い範囲から集められます。2025年後半に公開された計測は、規模では食い違っていますが、方向は一致しています。BrightEdgeの順位重複の追跡(2025年9月、引用の16.7%が上位10件から)とOriginality.AIの引用調査(2025年11月、52%)は、AI Overviewsの引用のうちオーガニック検索の上位10件から来たものの割合を約17%から52%の範囲に収めています。
ここで制御できるのは網羅性と形であり、ファンアウトそのものではありません。
- 役に立つ追加の質問をカバーします。 読者の役に立つなら、関連する情報はまとめておきます。個別のページは別々のニーズに応えるべきで、クエリのわずかな違いを狙うだけのものであってはいけません。GoogleのAI最適化ガイドは、主に順位やAIの回答を操作する目的でそのようなページを生成することに警告しています。
- 回答を表す見出しを使います。 読者が具体的な質問を持っている場合は、質問と回答の形式が役立つことがあります。しかしそれはAIに必須の形式ではなく、すべての記事をFAQにする理由にもなりません。
- 実質的な更新で新しさを保ちます。 これらのシステムでは新しさが特に重視されます。実質的な更新は内容を変えますが、日付だけを変えても何も変わらず、エンジンはそれをますます見抜くようになっています。
段階3:根拠づけ、そしてこの分野に名前を与えた発見
根拠づけとは、回答を選ばれた根拠に結びつけることです。ページの明確さや主張の裏づけは改善できますが、どの情報源や文章を使うかはエンジンが決めます。
GEOのベンチマーク研究(Aggarwalほか、2024年ACM SIGKDD Conference on Knowledge Discovery and Data Mining)は、約10,000件のクエリに対して9種類のコンテンツ変更を検証しました。効果が高かったのは、検証可能な統計の追加、信頼できる引用の組み込み、信頼できる情報源の明記でした。文章の流暢さの改善は効果が小さく、キーワードの詰め込みは効果がほとんどないか逆効果でした。
この論文の見出しの数字には注意してください。これを売り文句にしている代理店も含め、あらゆるところで誤って引用されているからです。よく繰り返される「40%の向上」は、位置で調整した語数の指標で19.8%を基準とした相対的な増加であり、すでにモデルのコンテキストに入れられた5つの情報源の間で測定されたものです。シミュレーター内での回答のシェアの結果であり、発見されるかどうかの指標ではありません。2026年7月に公開された45件の研究のスコーピングレビューはこの点を直接指摘しており、C-SEO Bench(NeurIPS 2025)は、こうした手法の多くが順位に対して効果がないか逆効果であり、従来のSEOのほうが優れていて、採用する人が増えるほど効果が縮むことを示しました。
実務上の教訓は、根拠を役に立つ検証可能なものにすることです。ベンチマークの可視性スコアを、自社サイトの予測に置き換えてはいけません。そのモデル、情報源の集合、プロンプト、採点方法は、実際の購入者の検索とは異なります。
編集のルールに置き換えると次のとおりです。
- 質問に明確に答えます。 重要な点を早めに示し、それを解釈するために必要な文脈を残します。決まった回答の長さはありません。
- 判断の助けになるときに数字を使います。 出典、期間、単位、限界を示します。文章を権威的に見せるためだけに統計を加えてはいけません。
- 重要な主張を根拠に結びつけます。 一次情報源があれば、読者は主張を確かめ、自分に当てはまるかを判断できます。
- 本物の表を使います。 選択肢、費用、ベンチマークをまとめたセマンティックなHTMLの表は、情報が密で曖昧さがなく、抽出しやすいものです。購入者が求めるのは比較なので、比較のコンテンツは特に多く取得されます。
- 確信の度合いを根拠に合わせます。 率直に書きつつ、購入者の判断を変えるような限界は残します。不確かな主張は、注意書きを削っても強くはなりません。
段階4:裏づけ、誰も取り組まない段階
独立した根拠があれば、主張は評価しやすくなります。だからといって、すべてのエンジンが独立した裏づけの手順を実行しているわけではなく、まとめ記事で主張を繰り返せば事実になるわけでもありません。正確な報道と有益な参加を目指し、捏造した言及や、独立した証拠を装ったコピーの主張は避けてください。
だからこそ、GEOはウェブサイトだけのプロジェクトではなくなります。裏づけを担う場は、あなたのものではありません。
- まとめ記事や「ベストX」リスト。 エンジンが組み立てようとしている比較を、あらかじめパッケージにしているからです。自分でリストを公開するより、他者のリストに載るほうが強い効果があります。
- コミュニティやフォーラム。 学習データにもリアルタイムの取得にも多く含まれています。本物の参加は積み重なり、スパムは除外されます。
- 獲得した報道や第三者の言及。 リンクのないものも含みます。リンクのない言及でも、ブランドとテーマの結びつきをモデルに教えることになり、思い出されるのはその結びつきです。
- 他者が引用する独自データ。 これは最も見返りの大きい手です。関係を逆転させるからです。言及を追いかける代わりに、誰もが引用せざるを得ない数字を公開するのです。あなたのデータが引用されるたびに、交渉せずに裏づけが得られます。
段階5:帰属、そして名指しされるか飛ばされるかの理由
最後の段階では、エンジンが「あなたによれば」と言うのか、単に内容だけを述べるのかが決まります。ここは最も制御しにくく、2つの要因がほとんどを決めます。
エンティティの明確さ。 モデルがあなたを名指しするには、あなたが誰なのかを十分な確信をもって知っている必要があります。社名の表記ゆれ、LinkedIn、Crunchbase、レビューサイトでのプロフィールの欠落や矛盾、事業内容のあいまいな説明は、いずれも帰属をリスクの高いものにし、エンジンはリスクの高い帰属を避けます。これを直すのは地味なデータの整備ですが、全体を支える重要な作業です。
出どころであること。 エンジンは、事実を繰り返しただけのサイトより、その事実の出どころに帰属させる傾向があります。数字があなたから生まれたなら、帰属は数字についてきます。他者の研究を要約しただけなら、引用はたいていその研究者に向かいます。これは独自データを支持する最も強い論拠であり、GEOの論拠ですらなく、単に引用に値する存在であるということです。
制御できないこと、そして試みるのをやめるべきこと
影響を与えられるパイプラインの外にあるものが3つあります。そうでないふりをすると、何四半期も無駄になります。
ファンアウト。 関連する検索はエンジンが選び、抽出した回答からすべての取得の判断が見えるわけではありません。読者の本当のニーズをカバーしてください。主に検索での可視性を操作するためにクエリのわずかな違いを量産することは、まさにGoogleが警告している問題です。
回答の言い回し。 モデルは言い換えます。モデルが何を根拠にするかには影響を与えられますが、結果をどう表現するかには決して影響を与えられません。
ユーザーがクリックするかどうか。 引用、訪問、購入は別々の判断です。可視性は、見込みのある訪問、問い合わせ、収益と合わせて追跡してください。プロンプトのパネルは回答のサンプルであり、コンバージョン率でも、特定の編集が成果をもたらした証拠でもありません。
当社サイトでパイプラインがもたらしたもの
私たちはこれを誰かに売る前にstrataigize.comで実践しました。だからこそ、具体的な数字を公開する気になれるのです。
以前のサイトで2025年後半に取り組み、2025-12-10に公開した施策では、ChatGPTに帰属するセッションが38から474に(エンゲージメント率は44.7%から53.8%に)、Perplexityは21から76に増え、2025-12-09時点でSemrushのAI引用は117件でした。両方のエンジンに直接帰属するリードも届きました。変化前後の詳しい表はAI SEOの事例にあります。私たちが始めた当時、AI検索は新興のチャネルでした。そうしたチャネルを早くテストする理由は、新興チャネルをテストする理由にまとめています。
収益の状況を、注意書きを添えて示します。当社のウェブサイトがこれまでに生んだクライアントはわずか2社で、どちらもAIの回答経由でした。合計で$215,603、当社の累計受注額の29.7%です。そのうち約95%は1件の案件です。これは、このチャネルが当社の案件規模で受注につながることを証明していますが、率については何も証明していません。これほど良い数字こそ誤用されやすいので、注意書きを添えたままにしています。
取り入れる価値のある構造上の落とし穴が1つあります。大きいほうの案件は当社のCRMで「Organic Search」とタグ付けされており、AIを介した経路だと明かしたのはクライアント自身でした。Googleは現在、AI OverviewsとAI Modeの表示回数について、別の生成AIのパフォーマンスレポートを文書化しています。これらの表示回数からは、どのリードがAIの回答をクリックしたかはわかりません。自社の可視性レポートと、購入者がどうやってあなたを見つけたかという説明は、別々の証拠として扱ってください。
エージェントが読める層、その実際の働き
私たちは、mcp.strataigize.comで公開のModel Context Protocol(MCP)サーバー、エージェント同士をつなぐエンドポイントも運用しており、Agent Skillsも公開しています。エージェントは、当社が公開している最新のコンテンツを読み、相談を依頼する流れを見つけられます。これによってそれらのインターフェースからサイトを使いやすくなりますが、検索での優位性が生まれるわけではありません。
今のところ、これは引用の決め手ではありません。機械が読めるエンドポイントやエージェントのマニフェストが、ChatGPTの回答であなたが名指しされるかどうかに影響するという実証はなく、根拠がない限り、そうでないふりをするつもりもありません。まず上記の5段階を整えてください。エージェントの層は、ポジショニングと将来への備えとして扱いましょう。
次に読むもの
- 用語でつまずいているならここから:アンサーエンジン最適化(AEO)、GEO、SEOの違い。
- わかりやすい入門:生成エンジン最適化とは。
- 自社で構築せずに依頼するなら:AI SEOサービスに含まれるものと代理店の見極め方。
- 各段階のためのツール:おすすめのAI SEOツール。
- 現状を確認する:AI可視性チェッカー、または当社の運用型生成エンジン最適化サービス。
よくある質問
AIクローラーをブロックすべきですか? 検索、学習、ユーザーの要求による取得を分けて判断してください。検索用クローラーをブロックするとコンテンツへの直接のアクセスを制限できますが、ブランドへのあらゆる言及が消えるわけではありません。アクセスを変更する前に、事業者の身元と、実際に有効なrobotsとファイアウォールのポリシーを確認してください。Googleについては、プロパティの検索の生成AIへの掲載設定も確認してください。
llms.txtは引用されるのに役立ちますか? 役立つという証拠はありません。公開する手間はほとんどかからず、エージェントの利用者に向けた整備としては妥当ですが、引用の戦略として売り込む代理店には警戒してください。決め手はコンテンツ、裏づけ、エンティティの明確さです。
AIエンジンはどのくらいの頻度でページを再確認しますか? 普遍的なスケジュールはありません。検索のインデックス登録、キャッシュされたコンテンツ、ユーザーの要求による取得は、それぞれ別の経路をたどります。検証済みのログと事業者のレポートを使って、自社サイトで何が起きたかを確認してください。新しさを装うために日付を変えるのではなく、重要な事実が変わったときに更新してください。
あるエンジンには表示され、別のエンジンには表示されないのはなぜですか? エンジンによって、取得の仕組み、製品の設定、情報源の選び方が異なります。結果はプロンプト、時間、場所、ユーザーの状況によっても変わります。引用が1つ見当たらないことをサイトの欠陥とみなす前に、それらの条件を記録し、計測を繰り返してください。
B2Bでは何か違いがありますか? 同じアクセスと根拠の確認が当てはまりますが、購買の際に必要な情報は異なります。B2Bの読者に向けては、取引先を評価するのに必要な情報を公開してください。対応範囲、実績の証拠、価格の目安、導入の要件、そして役に立つ次のステップです。可視性だけでなく、見込みのある問い合わせも計測してください。
お問い合わせ