Hoe generative engine optimization echt werkt
Generative engine optimization verbetert de geschiktheid en bruikbaarheid van een website als bron voor AI-antwoorden. Het praktische werk is crawlertoegang, heldere antwoorden onderbouwd met origineel bewijs, consistente bedrijfsinformatie en herhaalde metingen. Crawlen, ophalen, onderbouwen, bevestigen en toeschrijven vormen een bruikbaar model om hiaten te diagnosticeren, geen universele volgorde die elke engine volgt. U bepaalt wat u publiceert en hoe uw site reageert. Elke engine bepaalt wat hij ophaalt, citeert en zegt.
Werk aan Generative Engine Optimization (GEO) is makkelijker te beoordelen als u de onderdelen die u kunt verbeteren scheidt van de beslissingen die een engine neemt. De vijf fasen hieronder zijn ons diagnostisch model. Operators documenteren verschillende ophaalsystemen, en hun interne processen zijn niet volledig openbaar. Gebruik het model om ontbrekend bewijs of toegangsproblemen te vinden, niet om een citatie te beloven.
Wat echt bepaalt of u geciteerd wordt
- Crawlen, indexeren, citaties, bezoeken en aanvragen zijn verschillende uitkomsten. Een geslaagde fetch bewijst toegang; het bewijst geen selectie of vraag.
- Historische Cloudflare-tellingen op onze site tonen verzoeken die zich uitgeven als AI-fetchers. Die tellingen hebben verificatie door de operator nodig voordat ze kunnen vaststellen welke bots de verzoeken deden.
- Ophalen is niet uw ranking. Analyses van eind 2025 door BrightEdge en Originality.AI plaatsen het aandeel AI Overviews-citaties uit de organische top 10 tussen ruwweg 17% en 52%, dus geciteerd worden is een andere uitkomst dan gerankt worden.
- Publiceer bewijs dat een koper kan controleren: nuttige vergelijkingen, originele waarnemingen en bronnen voor wezenlijke beweringen. Experimentele zichtbaarheidsresultaten leveren geen universele stijging in citaties.
- Onafhankelijke bronnen kunnen kopers en zoeksystemen helpen een bewering te beoordelen. Een bewering op meerdere sites herhalen maakt haar niet waar.
De pijplijn, en waar de hefbomen zitten
| Fase | Wat de engine doet | Wat u beheerst | Sterkste hefboom |
|---|---|---|---|
| 1. Crawlen | Kan uw pagina ophalen of geïndexeerde content gebruiken | De reactie van de site, niet het crawlmoment | Crawlertoegang, rendersnelheid, statische HTML |
| 2. Ophalen | Splitst de vraag op in deelvragen en haalt kandidaatpassages op | Deels | Onderwerpdekking, relevantie van koppen voor de deelvraag, actualiteit |
| 3. Onderbouwen | Gebruikt geselecteerde bronnen om een antwoord te onderbouwen | Gepubliceerd bewijs, niet de bronkeuze | Heldere antwoorden, context, gelinkte bronnen |
| 4. Bevestigen | Kan een bewering vergelijken met ander bewijs | Het bewijs dat u levert, niet het oordeel van de engine | Onafhankelijke onderbouwing en originele data |
| 5. Toeschrijven | Beslist of en hoe een bron genoemd wordt | Nauwelijks | Duidelijkheid van de entiteit, de oorsprong van het feit zijn |
Alles hieronder is een wandeling door die tabel.
Fase 1: het crawlen, en de drie bots die niet dezelfde bot zijn
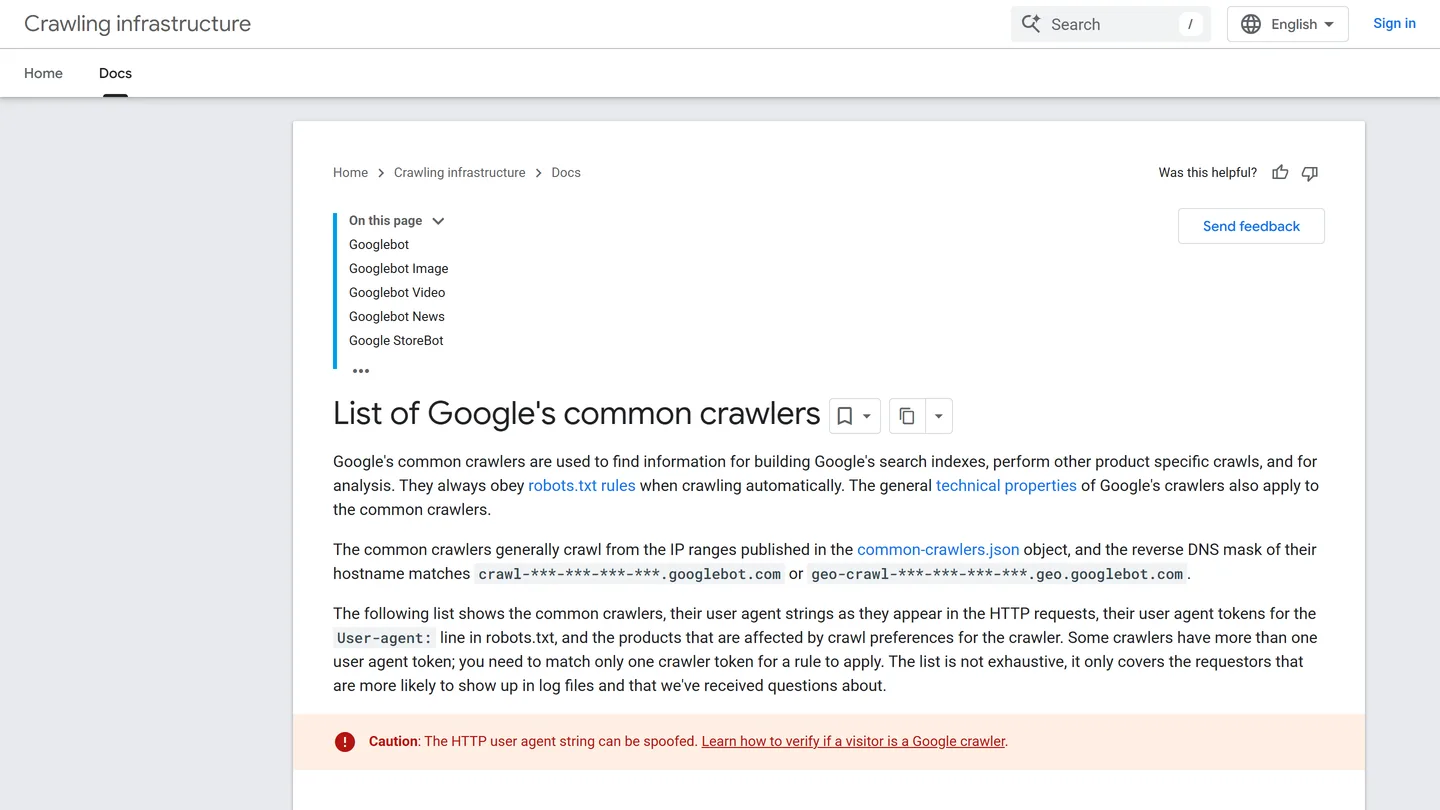
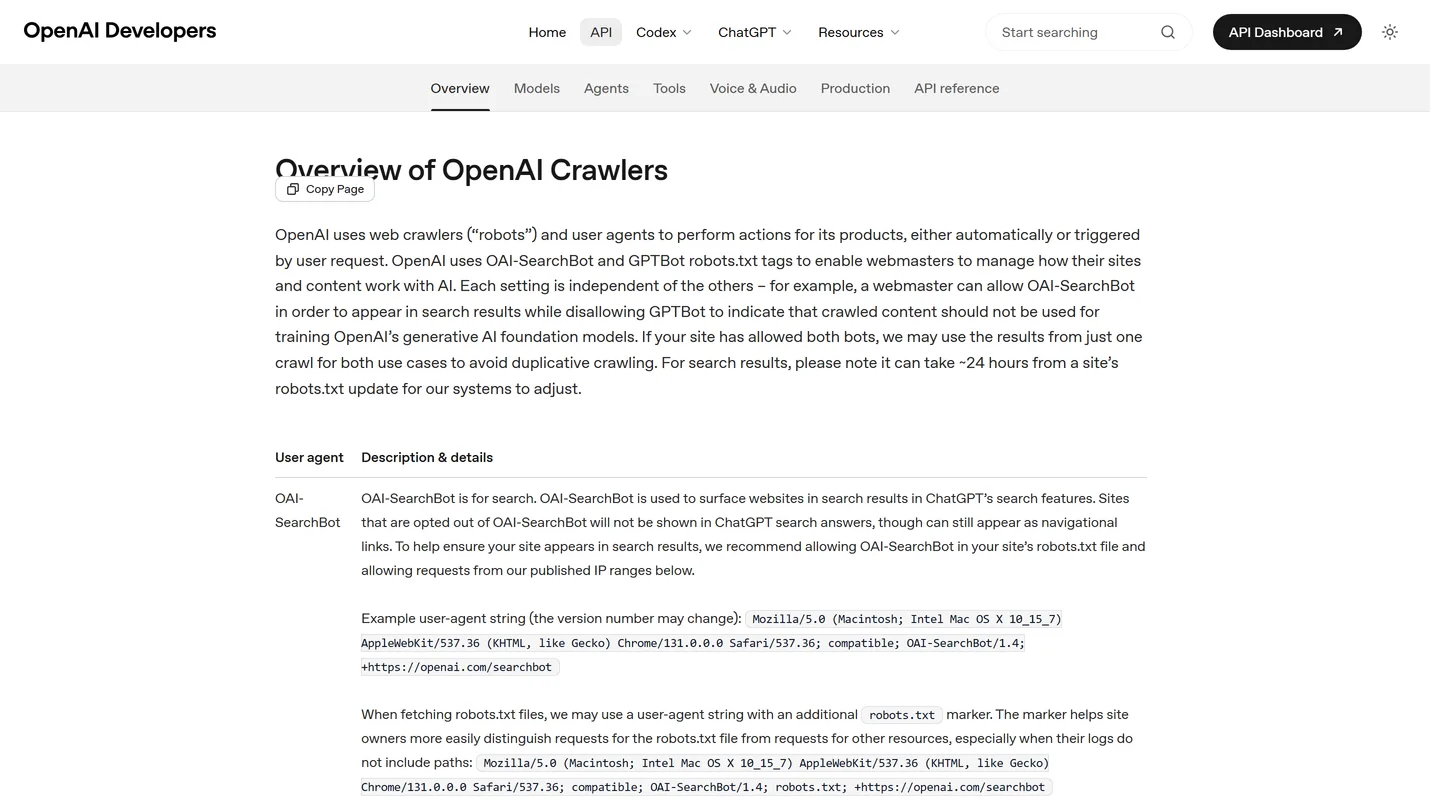
Zoekcrawlers, trainingscrawlers en fetchers op verzoek van gebruikers hebben verschillende taken. Directe toegang blokkeren kan beperken hoe uw pagina’s worden opgehaald, maar een merk kan nog steeds verschijnen via andere bronnen of bestaande indexdata.
Met de vloot van OpenAI als voorbeeld, gedocumenteerd in de botreferentie van OpenAI, zijn de rollen duidelijk verdeeld:
- GPTBot betreft content die gebruikt kan worden voor modeltraining. Het robots-beleid ervan staat los van SearchBot.
- De ChatGPT Search-crawler ondersteunt ChatGPT Search. Hem en zijn geverifieerde netwerkadressen toelaten ondersteunt toegang tot de bron; het garandeert geen opname.
- ChatGPT-User haalt content op voor acties van gebruikers. Een overeenkomende user-agentstring alleen bewijst noch de identiteit van de operator, noch een gekwalificeerde bezoeker.
Controleer de documentatie van elke operator. PerplexityBot ondersteunt zoeken; ClaudeBot betreft training, terwijl Claude-SearchBot zoeken ondersteunt. Google-Extended is een beleidstoken in robots.txt, geen aparte HTTP-crawler. Opname in Google Zoeken is een aparte instelling.
Ons historische lograpport over de week tot 27 juli 2026 telde 2 370 verzoeken die zich uitgaven als ChatGPT-User en 1 390 als Googlebot. Die totalen zijn ingedeeld op user agent. Ze kunnen zonder aanvullend identiteitsbewijs geen geverifieerd crawlervolume of menselijke vraag vaststellen. Houd opgegeven verzoeken gescheiden van geverifieerde bots, verwijzingen en leads.
Daar volgen twee controles uit. Belangrijke tekst en links moeten beschikbaar zijn in de teruggestuurde HTML, zodat ophalen niet afhangt van een crawler die uw scripts uitvoert. Google kan JavaScript renderen, maar ondersteuning voor renderen verschilt per systeem. Vergelijk daarnaast toegangslogs met analytics zonder ze als dezelfde populatie te behandelen: een bot-fetch is geen browsersessie.
Fase 2: ophalen, of waarom uw ranking uw citaties niet meer voorspelt
Sommige AI-zoekfuncties gebruiken query fan-out: ze zoeken naar gerelateerde vragen om bronnen voor een antwoord te verzamelen. Google documenteert dit gedrag voor zijn AI-functies. De exacte zoekopdrachten en het ophaalproces verschillen per product en verzoek, dus dit is geen universele volgorde die u uit één antwoord kunt terugredeneren.
Die opsplitsing is de reden dat ranking en citatie uit elkaar zijn gegroeid. U concurreert niet meer om één zoekopdracht, u concurreert om een waaier aan deelvragen die u nooit ziet, en de kandidatenset voor elke deelvraag wordt breder getrokken dan de top tien links. De gepubliceerde metingen van eind 2025 verschillen in omvang maar niet in richting: BrightEdge’s tracking van ranking-overlap (september 2025, 16,7% van de citaties uit de top 10) en het citatieonderzoek van Originality.AI (november 2025, 52%) plaatsen het aandeel AI Overviews-citaties uit de organische top 10 tussen ruwweg 17% en 52%.
Wat u hier beheerst is dekking en vorm, niet de fan-out zelf:
- Dek nuttige vervolgvragen af. Houd gerelateerde informatie bij elkaar als dat de lezer helpt. Aparte pagina’s moeten verschillende behoeften dienen, niet alleen op kleine zoekvariaties mikken. De richtlijnen voor AI-optimalisatie van Google waarschuwen tegen het genereren van zulke pagina’s vooral om rankings of AI-antwoorden te manipuleren.
- Gebruik koppen die het antwoord beschrijven. Een vraag-en-antwoordformaat kan helpen als lezers specifieke vragen hebben. Het is geen verplicht AI-formaat en geen reden om elk artikel in een FAQ te veranderen.
- Blijf actueel met echte updates. Recentheid weegt in deze systemen ongewoon zwaar. Een echte update verandert de inhoud; alleen de datum aanpassen verandert niets, en de engines prikken daar steeds vaker doorheen.
Fase 3: onderbouwen, en de bevinding die het vakgebied zijn naam gaf
Onderbouwen verbindt een antwoord met geselecteerd bewijs. U kunt de helderheid van uw pagina en de onderbouwing van een bewering verbeteren, maar de engine bepaalt welke bronnen en passages hij gebruikt.
Het GEO-benchmarkonderzoek (Aggarwal et al., de ACM SIGKDD Conference on Knowledge Discovery and Data Mining van 2024) testte negen contentaanpassingen op ruwweg 10 000 zoekopdrachten. De winnaars waren verifieerbare statistieken toevoegen, geloofwaardige citaten opnemen en betrouwbare bronnen aanhalen. Vloeiender formuleren hielp minder. Keyword stuffing had verwaarloosbare of negatieve effecten.
Wees voorzichtig met het kopgetal uit dat onderzoek, want het wordt overal verkeerd aangehaald, ook door bureaus die ertegen verkopen. De vaak herhaalde “40% stijging” is een relatieve winst ten opzichte van een basis van 19,8% op een voor positie gecorrigeerde woordtelmetriek, gemeten tussen vijf bronnen die al in de context van het model waren geplaatst. Het is een resultaat voor aandeel in het antwoord binnen een simulator, geen meting van of u gevonden wordt. Een scoping review van 45 onderzoeken, gepubliceerd in juli 2026, zegt dit rechtstreeks, en C-SEO Bench (NeurIPS 2025) vond dat de meeste van zulke methoden ineffectief of zelfs schadelijk zijn voor ranking, dat traditionele SEO ze overtreft en dat de winst krimpt naarmate meer mensen ze toepassen.
De praktische les is bewijs nuttig en verifieerbaar te maken. Maak van de zichtbaarheidsscore van een benchmark geen voorspelling voor uw site. De modellen, de bronnenset, de prompts en de scoringsmethode verschillen van de echte zoektocht van een koper.
Vertaald naar redactieregels:
- Beantwoord de vraag helder. Zet het belangrijke punt vooraan en behoud de context die nodig is om het te interpreteren. Er is geen verplichte antwoordlengte.
- Gebruik cijfers als ze de beslissing helpen. Geef de bron, periode, eenheden en beperkingen. Voeg geen statistieken toe alleen om een passage gezaghebbend te laten lijken.
- Koppel wezenlijke beweringen aan bewijs. Originele bronnen laten lezers een bewering controleren en beoordelen of die op hen van toepassing is.
- Gebruik echte tabellen. Semantische HTML-tabellen met opties, kosten of benchmarks zijn compact, ondubbelzinnig en makkelijk te extraheren. Vergelijkende content wordt onevenredig vaak opgehaald, omdat vergelijken precies is waar kopers om vragen.
- Stem zekerheid af op het bewijs. Schrijf direct, maar behoud beperkingen die de beslissing van een koper zouden veranderen. Een onzekere bewering wordt niet sterker als het voorbehoud wordt geschrapt.
Fase 4: bevestigen, de fase waar niemand aan werkt
Onafhankelijk bewijs kan een bewering makkelijker te beoordelen maken. Dat betekent niet dat elke engine een aparte bevestigingsstap uitvoert, of dat een bewering herhalen in lijstjesartikelen haar tot feit maakt. Zoek nauwkeurige berichtgeving en nuttige deelname; vermijd gefabriceerde vermeldingen of gekopieerde beweringen die als onafhankelijk bewijs worden gepresenteerd.
Daarom houdt GEO op een websiteproject te zijn. De plekken waar de bevestiging plaatsvindt, zijn plekken die u niet bezit:
- Overzichten en “beste X”-lijsten, omdat ze precies de vergelijking voorverpakken die een engine probeert te maken. In de lijst van een ander staan wint van uw eigen lijst publiceren.
- Community’s en fora, die sterk vertegenwoordigd zijn in zowel trainingsdata als live ophalen. Oprechte deelname stapelt zich op; spam laat u wegfilteren.
- Verdiende berichtgeving en vermeldingen door derden, ook zonder link. Een vermelding zonder link leert het model nog steeds een verband tussen uw merk en een onderwerp, en verbanden zijn wat onthouden wordt.
- Originele data die anderen aanhalen. Dit is de zet met de grootste opbrengst, omdat hij de verhouding omdraait: in plaats van vermeldingen na te jagen publiceert u het cijfer dat iedereen moet aanhalen. Elke citatie van uw data is een bevestiging waarover u niet hoefde te onderhandelen.
Fase 5: toeschrijven, en waarom u genoemd of overgeslagen wordt
De laatste fase bepaalt of de engine zegt “volgens u” of gewoon de inhoud zegt. Hier heeft u de minste controle, en twee factoren doen het meeste werk.
Duidelijkheid van de entiteit. Het model moet met genoeg zekerheid weten wie u bent om u te noemen. Inconsistente bedrijfsnamen, ontbrekende of tegenstrijdige profielen op LinkedIn, Crunchbase en reviewplatforms, en vage beschrijvingen van wat u doet maken toeschrijving allemaal riskant, en engines slaan riskante toeschrijvingen over. Dit oplossen is onopvallende datahygiëne, en alles rust erop.
De oorsprong zijn. Engines schrijven een feit eerder toe aan de bron ervan dan aan een site die het herhaalde. Als het cijfer bij u vandaan komt, volgt de toeschrijving het cijfer. Als u het onderzoek van een ander samenvatte, gaat de citatie meestal naar hen. Dit is het sterkste argument voor originele data dat er is, en het is helemaal geen GEO-argument, gewoon het waard zijn om geciteerd te worden.
Wat u niet kunt beheersen, en niet meer moet proberen
Drie dingen vallen buiten de pijplijn die u kunt beïnvloeden, en doen alsof dat anders is kost kwartalen.
De fan-out. Engines kiezen gerelateerde zoekopdrachten, en een steekproefantwoord onthult niet elke ophaalbeslissing. Dek echte behoeften van lezers af. Kleine zoekvarianten genereren vooral om zoekzichtbaarheid te manipuleren is precies het probleem waartegen Google waarschuwt.
De formulering van het antwoord. Het model parafraseert. U kunt beïnvloeden waarop het zich baseert, nooit hoe het het resultaat formuleert.
Of de gebruiker klikt. Citatie, bezoek en aankoop zijn afzonderlijke beslissingen. Volg zichtbaarheid naast gekwalificeerde bezoeken, aanvragen en omzet. Een promptpanel is een steekproef van antwoorden, geen conversieratio en geen bewijs dat een specifieke aanpassing winst opleverde.
Wat de pijplijn op onze eigen site opleverde
We hebben dit op strataigize.com toegepast voordat we het aan wie dan ook verkochten, en dat is de enige reden dat we bereid zijn details te publiceren.
Een offensief eind 2025 op de vorige site, gepubliceerd op 2025-12-10, bracht aan ChatGPT toegeschreven sessies van 38 naar 474 (betrokkenheidsratio van 44,7% naar 53,8%) en Perplexity van 21 naar 76, met 117 AI-citaties in Semrush per 2025-12-09. Er kwamen leads binnen die direct aan beide engines werden toegeschreven. De volledige voor-en-natabellen staan in de casestudy over AI-SEO. AI-zoeken was een opkomend kanaal toen we begonnen; waarom we zulke kanalen vroeg testen, leest u in waarom we opkomende kanalen testen.
Het omzetbeeld, met het voorbehoud erbij: de enige twee klanten die onze website ooit heeft opgeleverd, kwamen allebei via AI-antwoorden binnen, samen goed voor $215 603, oftewel 29,7% van onze totale gewonnen omzet. Ruwweg 95% daarvan is één deal. Dat bewijst dat het kanaal deals van onze omvang sluit en bewijst niets over een ratio. We houden het voorbehoud erbij, omdat een zo goed cijfer precies het soort cijfer is dat misbruikt wordt.
Eén structurele valkuil die het overnemen waard is: de grotere deal stond in ons CRM gelabeld als “Organic Search”, en de klant gaf zelf het door AI ondersteunde pad aan. Google documenteert nu een apart prestatierapport voor generatieve AI voor vertoningen in AI Overviews en AI Mode. Die vertoningen laten niet zien welke lead op een AI-antwoord klikte. Houd eigen zichtbaarheidsrapporten en het verhaal van de koper over hoe hij u vond als afzonderlijk bewijs.
De laag die agents kunnen lezen, zoals die echt werkt
We draaien ook een openbare Model Context Protocol-server (MCP) op mcp.strataigize.com, een agent-to-agent-endpoint, en hebben Agent Skills gepubliceerd. Agents kunnen onze huidige gepubliceerde content lezen en de aanvraagflow voor een adviesgesprek vinden. Dat maakt de site makkelijker te gebruiken via die interfaces; het levert geen voordeel in zoekresultaten op.
Wat het vandaag niet is, is een hefboom voor citaties. Machineleesbare endpoints en agentmanifesten hebben geen aangetoond effect op of ChatGPT u in een antwoord noemt, en we gaan niet doen alsof dat anders is zolang het bewijs ontbreekt. Bouw eerst de vijf fasen hierboven. Beschouw de agentlaag als positionering en toekomstbestendigheid.
Verder lezen
- Begin hier als de termen het probleem zijn: answer engine optimization (AEO), GEO en SEO uitgelegd.
- De introductie in gewone taal: wat generative engine optimization is.
- Inkopen in plaats van bouwen: wat AI-SEO-diensten omvatten en hoe u een bureau toetst.
- Tools voor elke fase: de beste AI-SEO-tools.
- Zie waar u nu staat: de AI-zichtbaarheidscheck of onze beheerde dienst voor generative engine optimization.
Veelgestelde vragen
Moet ik AI-crawlers blokkeren? Beslis afzonderlijk voor zoeken, training en ophalen op verzoek van gebruikers. Een zoekcrawler blokkeren kan directe toegang tot uw content beperken; het wist niet elke vermelding van uw merk. Controleer de identiteit van de operator en het daadwerkelijke robots- en firewallbeleid voordat u de toegang wijzigt. Controleer voor Google ook de instelling voor opname in generatieve AI van Zoeken van de property.
Helpt llms.txt om geciteerd te worden? Er is geen bewijs dat het helpt. Publiceren kost bijna niets en het is redelijke hygiëne voor gebruikers van agents, maar wees argwanend tegenover elk bureau dat het als citatiestrategie verkoopt. De hefbomen zijn content, bevestiging en duidelijkheid van de entiteit.
Hoe vaak controleren AI-engines een pagina opnieuw? Er is geen universeel schema. Zoekindexering, gecachete content en ophalen op verzoek van gebruikers volgen verschillende paden. Gebruik geverifieerde logs en de rapporten van de operator om te zien wat er op uw site gebeurde. Werk wezenlijke feiten bij als ze veranderen, in plaats van datums aan te passen om actualiteit te suggereren.
Waarom verschijn ik in de ene engine wel en in de andere niet? Engines gebruiken verschillende ophaalsystemen, productinstellingen en bronselecties. Resultaten kunnen ook verschillen per prompt, tijdstip, locatie en gebruikerscontext. Leg die omstandigheden vast en herhaal metingen voordat u één ontbrekende citatie als defect van de site behandelt.
Is dit anders voor B2B? Dezelfde controles op toegang en bewijs gelden, maar koopbehoeften verschillen. Publiceer voor B2B-lezers de informatie die ze nodig hebben om een leverancier te beoordelen: scope, bewijs, prijscontext, implementatie-eisen en een nuttige volgende stap. Meet naast zichtbaarheid ook gekwalificeerde aanvragen.
Praat met ons