Comment fonctionne vraiment l’optimisation GEO
L’optimisation pour les moteurs génératifs améliore l’admissibilité et l’utilité d’un site comme source pour les réponses IA. Le travail concret, c’est l’accès des robots, des réponses claires appuyées par une preuve originale, des renseignements d’entreprise cohérents, et une mesure répétée. L’exploration, la récupération, l’ancrage, la corroboration et l’attribution sont un modèle utile pour diagnostiquer les trous, pas une séquence universelle que chaque moteur suit. Vous contrôlez ce que vous publiez et comment votre site répond. Chaque moteur décide quoi récupérer, citer et dire.
Le travail d’optimisation pour les moteurs génératifs (GEO) est plus facile à évaluer quand vous séparez les parties que vous pouvez améliorer des décisions qu’un moteur prend. Les cinq étapes ci-dessous sont notre modèle de diagnostic. Les opérateurs documentent des systèmes de récupération différents, et leurs processus internes ne sont pas entièrement publics. Servez-vous du modèle pour trouver une preuve manquante ou un problème d’accès, pas pour promettre une citation.
Ce qui décide vraiment si vous êtes cité
- L’exploration, l’indexation, les citations, les visites et les demandes sont des issues différentes. Une récupération réussie prouve l’accès; elle ne prouve ni la sélection ni la demande.
- Des comptes Cloudflare historiques sur notre site montrent des requêtes qui se présentent comme des extracteurs IA. Ces comptes ont besoin d’une vérification d’opérateur avant de pouvoir établir quels robots ont fait les requêtes.
- La récupération n’est pas votre classement. Des analyses de fin 2025 par BrightEdge et Originality.AI placent la part des citations d’aperçus IA tirées du top 10 organique entre environ 17 % et 52 %, donc être cité est une issue séparée d’être classé.
- Publiez une preuve qu’un acheteur peut vérifier : des comparaisons utiles, des observations originales et des sources pour les affirmations matérielles. Des résultats de visibilité expérimentaux ne fournissent pas un gain de citation universel.
- Des sources indépendantes peuvent aider les acheteurs et les systèmes de recherche à évaluer une affirmation. Répéter une assertion sur plusieurs sites ne la rend pas vraie.
Le pipeline, et où sont les leviers
| Étape | Ce que le moteur fait | Ce que vous contrôlez | Levier le plus fort |
|---|---|---|---|
| 1. Explorer | Peut récupérer votre page ou utiliser du contenu indexé | La réponse du site, pas le moment de l’exploration | Accès des robots, vitesse de rendu, HTML statique |
| 2. Récupérer | Découpe la question en sous-questions, tire des passages candidats | En partie | Couverture du sujet, pertinence des titres pour la sous-question, fraîcheur |
| 3. Ancrer | Utilise des sources choisies pour appuyer une réponse | La preuve publiée, pas le choix des sources | Réponses claires, contexte, sources liées |
| 4. Corroborer | Peut comparer une affirmation à d’autres preuves | La preuve que vous fournissez, pas le jugement du moteur | Soutien indépendant et données originales |
| 5. Attribuer | Décide s’il nomme une source et comment | À peine | Clarté de l’entité, être l’origine du fait |
Tout ce qui suit est une promenade dans ce tableau.
Étape 1 : l’exploration, et les trois robots qui ne sont pas le même robot
Les robots de recherche, les robots d’entraînement et les extracteurs demandés par un utilisateur ont des emplois différents. Bloquer l’accès direct peut limiter la façon dont vos pages sont récupérées, mais une marque peut encore apparaître par d’autres sources ou par des données d’index déjà présentes.
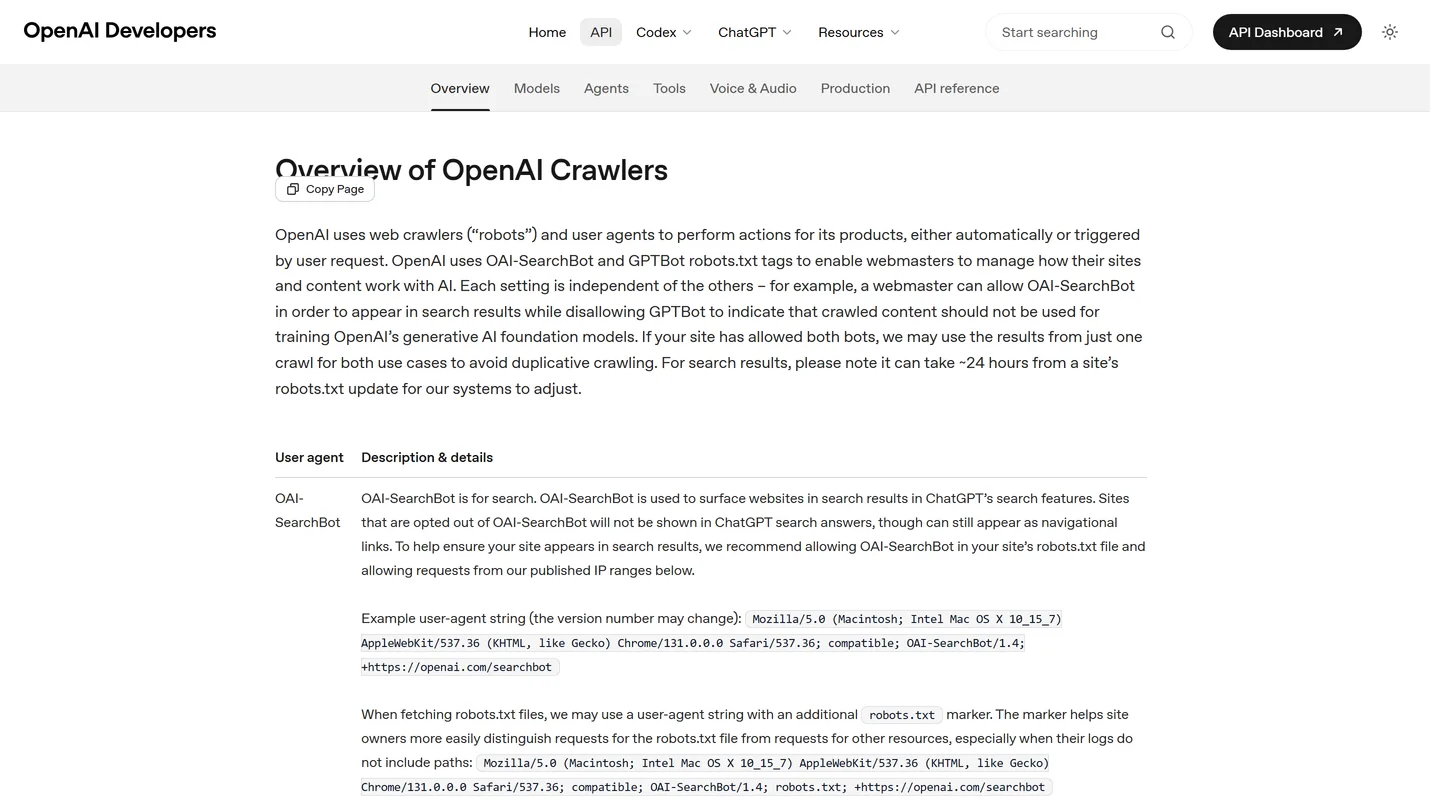
En prenant la flotte d’OpenAI comme exemple, documentée dans la référence des robots d’OpenAI, les rôles se séparent nettement :
- GPTBot concerne le contenu qui peut servir à l’entraînement d’un modèle. Sa politique robots est indépendante de SearchBot.
- Le robot de recherche ChatGPT soutient la recherche ChatGPT. L’autoriser, ainsi que ses adresses réseau vérifiées, soutient l’accès aux sources; cela ne garantit pas l’inclusion.
- ChatGPT-User récupère du contenu pour des actions d’utilisateur. Une chaîne d’agent utilisateur correspondante seule ne prouve ni l’identité de l’opérateur ni un visiteur qualifié.
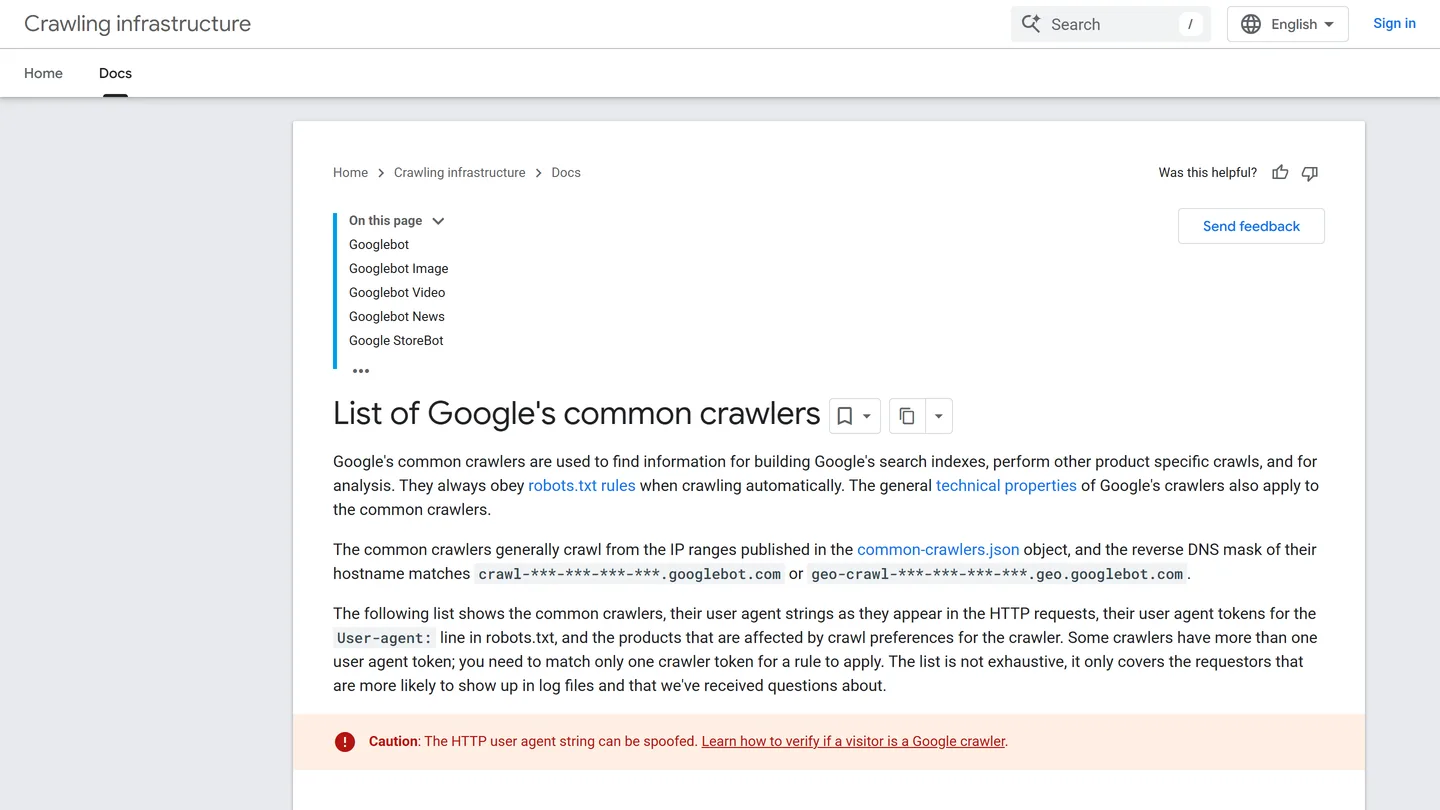
Vérifiez la documentation de chaque opérateur. PerplexityBot soutient la recherche; ClaudeBot concerne l’entraînement, tandis que Claude-SearchBot soutient la recherche. Google-Extended est un jeton de politique robots.txt, pas un robot HTTP distinct. L’inclusion dans Google Search est un contrôle séparé.
Notre rapport de journaux historique pour la semaine au 27 juillet 2026 a compté 2 370 requêtes se présentant comme ChatGPT-User et 1 390 se présentant comme Googlebot. Ces totaux ont été classés par agent utilisateur. Ils ne peuvent pas établir un volume de robots vérifié ni une demande humaine sans autre preuve d’identité. Gardez les requêtes déclarées séparées des robots vérifiés, des références et des pistes.
Deux contrôles suivent. Le texte et les liens importants devraient être disponibles dans le HTML renvoyé, pour que la récupération ne dépende pas d’un robot qui exécute vos scripts. Google peut rendre le JavaScript, mais le soutien au rendu diffère selon les systèmes. Comparez aussi les journaux d’accès aux analyses sans les traiter comme la même population : une récupération de robot n’est pas une session de navigateur.
Étape 2 : la récupération, ou pourquoi votre classement a cessé de prédire vos citations
Certaines fonctions de recherche IA utilisent le « fan-out » de requêtes : elles cherchent des questions liées pour rassembler des sources pour une réponse. Google documente ce comportement pour ses fonctions IA. Les requêtes exactes et le processus de récupération varient selon le produit et la demande, donc ce n’est pas une séquence universelle que vous pouvez rétro-ingénierer à partir d’une réponse.
Cette décomposition explique pourquoi classement et citation se sont séparés. Vous ne rivalisez plus pour une seule requête, vous rivalisez pour une gerbe de sous-questions que vous ne voyez jamais, et l’ensemble de candidats de chacune est tiré plus largement que les dix premiers liens. Les mesures publiées de fin 2025 ne s’entendent pas sur l’ampleur, mais oui sur la direction : le suivi de recouvrement de rang de BrightEdge (septembre 2025, 16,7 % des citations issues du top 10) et l’étude de citations d’Originality.AI (novembre 2025, 52 %) encadrent la part des citations d’aperçus IA tirées du top 10 organique entre environ 17 % et 52 %.
Ce que vous contrôlez ici, c’est la couverture et la forme, pas le fan-out lui-même :
- Couvrez les questions de suivi utiles. Gardez les renseignements liés ensemble quand cela aide le lecteur. Des pages séparées devraient servir des besoins distincts, pas seulement viser de petites variations de requête. Le guide d’optimisation IA de Google met en garde contre la production de telles pages surtout pour manipuler les classements ou les réponses IA.
- Utilisez des titres qui décrivent la réponse. Un format question-réponse peut aider quand les lecteurs ont des questions précises. Ce n’est pas un format IA exigé ni une raison de transformer chaque article en FAQ.
- Restez frais avec de vraies mises à jour. La récence pèse de façon inhabituelle dans ces systèmes. Une vraie mise à jour change le contenu; un recul de date ne change rien et les moteurs le voient de plus en plus.
Étape 3 : l’ancrage, et le constat qui a nommé le champ
L’ancrage relie une réponse à une preuve choisie. Vous pouvez améliorer la clarté de votre page et le soutien d’une affirmation, mais le moteur contrôle quelles sources et quels passages il utilise.
L’étude de référence GEO (Aggarwal et al., conférence ACM SIGKDD 2024 sur la découverte de connaissances et l’exploration de données) a testé neuf modifications de contenu sur environ 10 000 requêtes. Les gagnantes étaient l’ajout de statistiques vérifiables, l’intégration de citations crédibles et le renvoi à des sources fiables. Améliorer la fluidité aidait moins. Le bourrage de mots-clés a produit des effets négligeables ou négatifs.
Méfiez-vous du chiffre titré de cet article, parce qu’il est mal cité partout, y compris par des agences qui vendent contre lui. Le « gain de 40 % » souvent répété est un gain relatif sur une base de 19,8 % sur une métrique de nombre de mots ajustée à la position, mesurée parmi cinq sources déjà injectées dans le contexte du modèle. C’est un résultat de part de réponse dans un simulateur, pas une mesure de savoir si on vous découvre. Une revue de cadrage de 45 études publiée en juillet 2026 le dit directement, et C-SEO Bench (NeurIPS 2025) a trouvé que la plupart de ces méthodes sont inefficaces ou activement négatives sur le classement, le SEO traditionnel les surpassant, et les gains rétrécissant à mesure que plus de gens les adoptent.
La leçon pratique est de rendre la preuve utile et vérifiable. Ne transformez pas le score de visibilité d’une référence en prévision pour votre site. Ses modèles, son ensemble de sources, ses consignes et sa méthode de notation diffèrent de la recherche d’un acheteur en direct.
Traduit en règles d’édition :
- Répondez clairement à la question. Placez le point important tôt et conservez le contexte nécessaire pour l’interpréter. Il n’y a pas de longueur de réponse exigée.
- Utilisez des chiffres quand ils aident la décision. Donnez la source, la période, les unités et les limites. N’ajoutez pas de statistiques seulement pour faire paraître un passage autoritaire.
- Liez les affirmations matérielles à une preuve. Les sources originales laissent les lecteurs vérifier une affirmation et juger si elle s’applique à eux.
- Utilisez de vrais tableaux. Des tableaux HTML sémantiques d’options, de coûts ou de références sont denses, non ambigus et faciles à extraire. Le contenu comparatif est récupéré de façon disproportionnée parce que la comparaison est ce que les acheteurs demandent.
- Alignez la certitude sur la preuve. Écrivez directement, mais gardez les limites qui changeraient la décision d’un acheteur. Une affirmation incertaine ne devient pas plus forte quand on retire sa réserve.
Étape 4 : la corroboration, l’étape sur laquelle personne ne travaille
Une preuve indépendante peut rendre une affirmation plus facile à évaluer. Cela ne veut pas dire que chaque moteur exécute une étape de corroboration séparée, ni que répéter une affirmation dans des listicles en fait un fait. Cherchez une couverture exacte et une participation utile; évitez les mentions fabriquées ou les assertions copiées présentées comme une preuve indépendante.
C’est pourquoi le GEO cesse d’être un projet de site Web. Les surfaces qui corroborent sont des surfaces que vous ne possédez pas :
- Les recensions et les listes « meilleurs X », parce qu’elles préemballent exactement la comparaison qu’un moteur essaie de construire. Être dans la liste de quelqu’un d’autre bat de publier la vôtre.
- Les communautés et les forums, fortement représentés à la fois dans les données d’entraînement et dans la récupération en direct. Une participation vraie se compose; le pourriel vous fait filtrer.
- La couverture gagnée et les mentions de tiers, y compris les mentions sans lien. Une mention sans lien enseigne encore au modèle une association entre votre marque et un sujet, et les associations sont ce qui se rappelle.
- Des données originales que d’autres gens citent. C’est le geste au plus grand rendement, parce qu’il inverse la relation : au lieu de courir après les mentions, vous publiez le chiffre que tout le monde doit citer. Chaque citation de vos données est un événement de corroboration que vous n’avez pas eu à négocier.
Étape 5 : l’attribution, et pourquoi on vous nomme ou on vous saute
La dernière étape décide si le moteur dit « selon vous » ou s’il dit simplement la chose. Vous avez le moins de contrôle ici, et deux facteurs font la plus grande part du travail.
La clarté de l’entité. Le modèle a besoin de savoir qui vous êtes avec assez de confiance pour vous nommer. Des noms d’entreprise incohérents, des profils manquants ou contradictoires sur LinkedIn, Crunchbase et les plateformes d’avis, et des descriptions vagues de ce que vous faites rendent l’attribution risquée, et les moteurs sautent les attributions risquées. Corriger cela, c’est de l’hygiène de données peu glamour, et c’est porteur.
Être l’origine. Les moteurs attribuent plus volontiers à la source d’un fait qu’à un site qui l’a répété. Si le chiffre est parti de vous, l’attribution suit le chiffre. Si vous avez résumé la recherche de quelqu’un d’autre, la citation va d’habitude vers eux. C’est l’argument le plus fort qui existe pour des données originales, et ce n’est pas un argument GEO du tout, juste le fait d’être digne d’être cité.
Ce que vous ne pouvez pas contrôler, et devriez cesser d’essayer
Trois choses sont hors du pipeline que vous pouvez influencer, et faire semblant du contraire brûle des trimestres.
Le fan-out. Les moteurs choisissent les recherches liées, et une réponse échantillonnée n’expose pas chaque décision de récupération. Couvrez de vrais besoins de lecteurs. Produire de légères variantes de requêtes surtout pour manipuler la visibilité de recherche est le problème contre lequel Google met en garde.
Le libellé de la réponse. Le modèle paraphrase. Vous pouvez influencer ce sur quoi il s’ancre, jamais comment il formule le résultat.
Si l’utilisateur clique. Citation, visite et achat sont des décisions séparées. Suivez la visibilité en parallèle des visites qualifiées, des demandes et du revenu. Un panneau de consignes est un échantillon de réponses, pas un taux de conversion ni la preuve qu’une retouche précise a causé un gain.
Ce que le pipeline a produit sur notre propre site
Nous l’avons fait tourner sur strataigize.com avant de le vendre à qui que ce soit, ce qui est la seule raison pour laquelle nous acceptons de publier des précisions.
Une poussée de fin 2025 sur le site précédent, publiée le 10 décembre 2025, a fait passer les sessions attribuées à ChatGPT de 38 à 474 (taux d’engagement de 44,7 % à 53,8 %) et Perplexity de 21 à 76, avec 117 citations IA Semrush au 9 décembre 2025. Des pistes sont arrivées attribuées directement aux deux moteurs. Les tableaux complets avant-après sont dans l’étude de cas SEO IA. La recherche IA était un canal émergent quand nous avons commencé; la raison pour laquelle nous testons tôt est dans pourquoi nous testons les canaux émergents.
Le portrait du revenu, énoncé avec sa réserve attachée : les deux seuls clients que notre site Web a jamais produits sont arrivés par des réponses IA, d’une valeur de 215 603 $ ensemble, soit 29,7 % de notre revenu gagné-fermé à vie. Environ 95 % de cela est une seule affaire. Cela prouve que le canal ferme à la taille de nos affaires et ne prouve rien sur un taux. Nous gardons la réserve attachée parce qu’un chiffre aussi bon est exactement le genre qu’on détourne.
Un piège structurel qui vaut d’être volé : la plus grosse affaire était étiquetée « Organic Search » dans notre CRM, et le client a identifié le parcours assisté par l’IA. Google documente maintenant un rapport de performance IA générative distinct pour les impressions des aperçus IA et du mode IA. Ces impressions n’identifient pas quelle piste a cliqué une réponse IA. Gardez les rapports de visibilité de première partie et le récit de l’acheteur sur la façon dont il vous a trouvé comme des preuves séparées.
La couche lisible par les agents, telle qu’elle fonctionne vraiment
Nous faisons aussi tourner un serveur public Model Context Protocol (MCP), le protocole de contexte du modèle, à mcp.strataigize.com, un point de terminaison d’agent à agent, et des compétences d’agent publiées. Les agents peuvent lire notre contenu publié actuel et découvrir le flux de demande de consultation. Cela rend le site plus facile à utiliser par ces interfaces; cela n’établit pas un avantage de recherche.
Ce que ce n’est pas, aujourd’hui, c’est un levier de citation. Les points de terminaison lisibles par machine et les manifestes d’agents n’ont aucun effet démontré sur le fait que ChatGPT vous nomme dans une réponse, et nous n’allons pas faire semblant du contraire tant que la preuve est absente. Bâtissez d’abord les cinq étapes ci-dessus. Traitez la couche agent comme du positionnement et de l’anticipation.
Où aller ensuite
- Commencez ici si les termes sont le problème : optimisation pour les moteurs de réponse (AEO) contre GEO contre SEO expliqués.
- L’introduction en langage simple : ce qu’est l’optimisation pour les moteurs génératifs.
- Acheter plutôt que bâtir : ce que les services de SEO IA incluent et comment juger une agence.
- L’outillage pour chaque étape : les meilleurs outils de SEO IA.
- Voir où vous en êtes : le vérificateur de visibilité IA, ou notre service d’optimisation pour les moteurs génératifs géré.
Questions fréquentes
Devrais-je bloquer les robots IA? Décidez séparément pour la recherche, l’entraînement et la récupération demandée par un utilisateur. Bloquer un robot de recherche peut limiter l’accès direct à votre contenu; cela n’efface pas chaque mention de votre marque. Vérifiez l’identité de l’opérateur et les politiques robots et pare-feu effectives avant de changer l’accès. Pour Google, vérifiez aussi le réglage d’inclusion IA générative de la Recherche de la propriété.
Est-ce que llms.txt m’aide à être cité? Il n’y a aucune preuve que oui. Cela ne coûte presque rien à publier et c’est une hygiène raisonnable pour les consommateurs agents, mais traitez avec soupçon toute agence qui le vend comme stratégie de citation. Les leviers sont le contenu, la corroboration et la clarté de l’entité.
À quelle fréquence les moteurs IA revérifient-ils une page? Il n’y a pas d’horaire universel. L’indexation de recherche, le contenu en cache et la récupération demandée par un utilisateur suivent des chemins différents. Servez-vous de journaux vérifiés et des rapports de l’opérateur pour voir ce qui s’est passé sur votre site. Mettez à jour les faits matériels quand ils changent plutôt que de reculer les dates pour suggérer de la fraîcheur.
Pourquoi apparais-je dans un moteur et pas dans un autre? Les moteurs utilisent des systèmes de récupération, des réglages de produit et des choix de sources différents. Les résultats peuvent aussi varier selon la consigne, le moment, le lieu et le contexte de l’utilisateur. Notez ces conditions et répétez les mesures avant de traiter une citation manquante comme un défaut du site.
Est-ce différent en B2B? Les mêmes contrôles d’accès et de preuve s’appliquent, mais les besoins d’achat varient. Pour les lecteurs B2B, publiez les renseignements dont ils ont besoin pour évaluer un fournisseur : portée, preuve, contexte de prix, exigences de mise en œuvre et une prochaine étape utile. Mesurez les demandes qualifiées autant que la visibilité.
Parlez-nous