Was eine KI-Evaluation tatsächlich misst
Ein Benchmark-Wert sagt Ihnen, wie ein Modell bei einem festen Satz von Fragen abgeschnitten hat, bewertet auf eine bestimmte Weise. Er sagt Ihnen nicht, ob das Modell mit Ihren Daten funktioniert. Eine Untersuchung von 445 Benchmarks für Sprachmodelle aus dem Jahr 2025 ergab, dass nur 16 % ihre Ergebnisse überhaupt statistisch getestet haben, und eine separate Arbeit zeigt, dass etwa die Hälfte der getesteten Modelle Benchmark-Inhalte bereits im Training gesehen hatte. Bevor Sie ein KI-System kaufen, bauen Sie einen kleinen, annotierten Satz aus Ihren eigenen realen Fällen und messen Sie daran.
Jede Präsentation eines KI-Anbieters enthält ein Diagramm, in dem dessen Balken höher ist als die anderen. Das Diagramm stimmt meist. Es ist aber meist auch irrelevant für die Frage, die der Käufer tatsächlich stellt: ob das Ding mit seinen eigenen Dokumenten, seinen eigenen Tickets, seinen eigenen Bildern funktioniert.
Diese Lücke ist keine Unehrlichkeit des Marketings. Sie ist ein Messproblem, und sie ist sorgfältig genug dokumentiert, dass Sie selbst danach suchen können.
Ein Benchmark ist ein Instrument, und Instrumente müssen validiert werden
In den Wissenschaften, die Dinge messen, die man nicht direkt sehen kann, muss sich ein Messinstrument Vertrauen verdienen, bevor seine Werte etwas bedeuten. Die gemessene Eigenschaft muss definiert sein. Es muss gezeigt werden, dass der Test diese Eigenschaft misst und nicht etwas, das mit ihr korreliert. Das Ergebnis braucht eine Schätzung, wie viel davon Rauschen ist. Die Psychometrie nennt das Konstruktvalidität, und es ist gängige Praxis.
Benchmarks für Sprachmodelle sind genau solche Instrumente. „Schlussfolgern“ und „Hilfsbereitschaft“ sind nicht direkt beobachtbar, also steht ein Benchmark stellvertretend für sie. Ob dieser Stellvertreter funktioniert, lässt sich beantworten, und 2025 hat ein Team von 29 Gutachtern diese Frage für 445 Benchmarks aus führenden Konferenzen zu Sprachverarbeitung und maschinellem Lernen beantwortet, in einer Arbeit, die im Datasets and Benchmarks Track der NeurIPS 2025 erschienen ist.
Die Zahlen lohnen langsames Lesen:
- 16,0 % führten überhaupt statistische Tests oder Unsicherheitsschätzungen durch. Die übrigen 84 % melden eine Zahl ohne Hinweis darauf, wie stark sie sich bei einem erneuten Durchlauf verändern würde.
- 47,8 % der Benchmarks, die ihr Ziel überhaupt definierten, maßen ein umstrittenes Phänomen, also etwas, dessen Definition in der Fachwelt nicht geklärt ist.
- 81,3 % bewerteten mit exaktem Zeichenkettenabgleich, und 40,7 % nutzten nichts anderes. Eine richtige Antwort mit anderer Formulierung zählt als falsch.
- 42,6 % verwendeten Aufgaben aus bestehenden Benchmarks wieder. So wandert ein Fehler in einem Test in die Tests, die ihn eigentlich prüfen sollten.
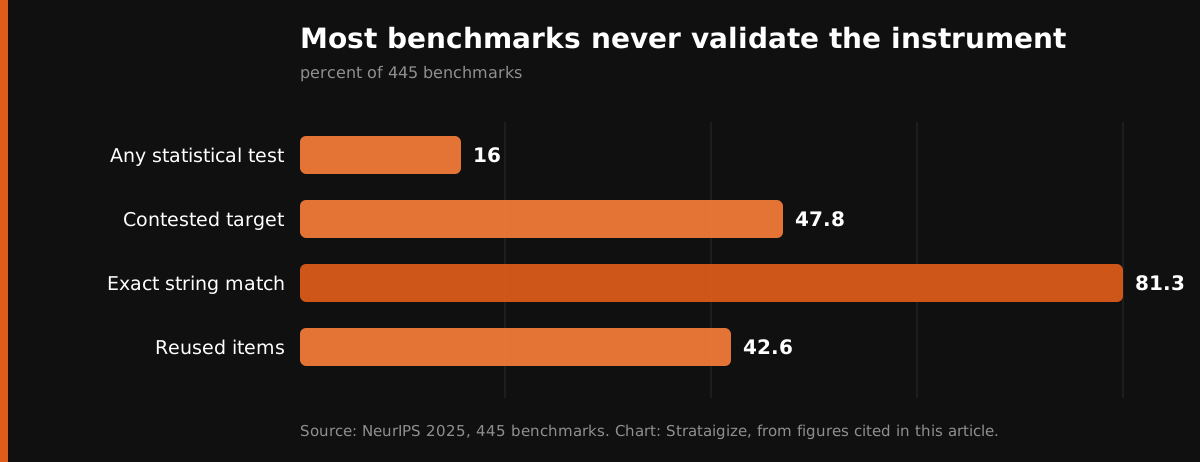
Die meisten der 445 Benchmarks haben das Instrument nie validiert. Quelle: NeurIPS 2025, Measuring what Matters.
Das heißt nicht, dass die Benchmarks wertlos sind. Es heißt, dass ein Benchmark-Wert eine schwächere Aussage ist, als er wirkt, und dass die Stärke der Aussage selten danebensteht.
Das Kontaminationsproblem macht die Zahl noch weicher
Ein Benchmark funktioniert nur, wenn das Modell die Antworten nicht schon gesehen hat. Moderne Trainingskorpora sind groß genug und breit genug zusammengetragen, dass sich das schwer garantieren und leicht falsch machen lässt.
Forschende der Shanghai Jiao Tong University testeten 31 Modelle auf Anzeichen von Benchmark-Leakage bei GSM8K und MATH, zwei Datensätzen für mathematisches Schlussfolgern, und nutzten Perplexität und die Genauigkeit der N-Gramm-Vorhersage, um Auswendiglernen zu erkennen. Etwa die Hälfte zeigte Anzeichen, mit Benchmark-Daten trainiert worden zu sein. Im deutlichsten Fall reproduzierte Qwen-1.8B jede Folge von fünf Wörtern in 223 Beispielen aus dem Trainingssatz von GSM8K, 67 aus dem Trainingssatz von MATH und 25 aus dem Testsatz von MATH, also dem Teil, dessen ganzer Zweck darin besteht, ungesehen zu sein.
Ein Modell, das einen Teil eines Tests auswendig gelernt hat, schneidet darin gut ab und sagt Ihnen nichts über seine Leistung bei allem anderen. Von außen sieht das genauso aus wie ein Modell, das einfach gut ist.
Wie das in der Forschung aussah
In meiner Promotion ging es darum, vortrainierte Modelle ohne annotierte Beispiele visuelle Aufgaben lösen zu lassen, für die sie nie trainiert wurden: zuerst das Finden semantischer Korrespondenzen mit einem Diffusionsmodell auf der NeurIPS 2023, dann Keypoints aus derselben Modellklasse auf der Konferenz Computer Vision and Pattern Recognition 2024. Beide wurden an annotierten Standard-Benchmarks gemessen, weil die Fachwelt Methoden so vergleicht.
Diese Zahlen waren echt, und die Vergleiche waren fair. Sie konnten aber nicht die Frage beantworten, die ein Unternehmen stellen würde: ob die Methode mit seinen Bildern funktioniert, in seiner Auflösung, bei seiner Beleuchtung, nach seiner Definition einer richtigen Antwort. Benchmark-Leistung und Leistung im Einsatz sind unterschiedliche Messungen. Wer ein Modell schon einmal vom Paper in ein Produkt gebracht hat, hat diese Lücke gesehen.
Die Evaluation, die Sie selbst bauen, ist die einzige, die auf Ihre Entscheidung zugeschnitten ist
Die Lösung ist unspektakulär, und sie funktioniert. Bevor Sie sich auf ein KI-System festlegen, stellen Sie eine Sammlung realer Fälle aus Ihrem eigenen Betrieb zusammen und annotieren das richtige Ergebnis von Hand. Das ist der nützlichste halbe Tag, den jemand in ein KI-Projekt steckt.
Ziehen Sie Stichproben aus der Realität, nicht aus den einfachen Fällen. Nehmen Sie echte Leads, echte Tickets, echte Rechnungen, echte Fotos, auch die fehlerhaften. Ein Satz, der nur aus sauberen Beispielen besteht, misst ein System, das Sie nicht haben.
Streben Sie zum Start 100 bis 300 annotierte Einträge an. Genug, um ein System, das meistens richtig liegt, von einem zu unterscheiden, das nur etwas öfter als der Zufall richtig liegt, und wenig genug, dass eine Person es tatsächlich an einem Nachmittag schafft.
Schreiben Sie auf, was richtig bedeutet, bevor Sie eine Ausgabe ansehen. Zwei Personen im selben Team sind sich oft uneinig, ob ein Lead qualifiziert war oder ein Dokument richtig abgelegt wurde. Diese Uneinigkeit auf Papier zu klären lohnt sich unabhängig davon, ob Sie etwas kaufen, und wer es hinterher tut, biegt die Definition passend zum Ergebnis.
Kennzeichnen Sie mehrdeutige Fälle als mehrdeutig. Wer einem Fall, den Ihr eigenes Team eskalieren würde, eine Ja-Nein-Antwort aufzwingt, baut einen Test, der richtiges Verhalten bestraft.
Halten Sie einen Teil zurück. Behalten Sie einen Anteil, den niemand sieht, der das System baut oder abstimmt, auch Ihr Anbieter nicht. Dieser zurückgehaltene Teil ist der einzige, dessen Ergebnis Sie für bare Münze nehmen können.
Erfassen Sie die Uneinigkeitsrate zwischen Ihren eigenen Annotierenden. Wenn zwei Ihrer Leute in 85 % der Fälle übereinstimmen, arbeitet ein System mit 85 % bei Ihrer Aufgabe auf menschlichem Niveau, und ein Anbieter, der 99 % verspricht, misst entweder etwas anderes oder hat Ihre Antworten gesehen.
Was Sie einen Anbieter fragen sollten
Die nützlichen Fragen betreffen die Methode, nicht den Wert.
Fragen Sie, woran die gemeldete Zahl gemessen wurde und ob das System auf genau diesen Daten abgestimmt wurde. Fragen Sie nach der Leistung bei den Fällen, in denen es falsch liegt, denn Fehleranalyse fehlte in den 445 untersuchten Benchmarks weitgehend, und dort liegt meist das betriebliche Risiko. Fragen Sie, wie die Zahl bei einem Satz aussähe, den der Anbieter nie gesehen hat, und liefern Sie dann einen. Fragen Sie nach einem Konfidenzintervall oder nach dem Ergebnis, wenn die Evaluation mehr als einmal durchgeführt wird.
Ein Anbieter, der diese Fragen beantworten kann, macht die Arbeit. Ein Anbieter, der nur mit einem Ranglistenplatz antwortet, hat Ihnen gesagt, wo er im Test von jemand anderem steht.
Wie wir das anwenden
Jedes System in unserem Katalog an KI-Systemen folgt einer festen Abfolge, und der zweite Schritt ist, dass ein von Hand annotierter Satz realer Fälle des Kunden vereinbart wird, bevor irgendjemand über eingesparte Stunden spricht. Nichts wird auf Grundlage eines Benchmark-Werts skaliert. Das AI Opportunity Audit, mit dem die meisten Mandate beginnen, liefert diesen annotierten Satz als Ergebnis, und er gehört Ihnen, ob wir danach etwas bauen oder nicht.
Die Evaluation ist auch das, was eine schriftliche Abbruchschwelle sinnvoll macht. Im Voraus zu vereinbaren, bei einem bestimmten Leistungsniveau aufzuhören, ist ein leeres Versprechen, solange es keine vereinbarte Methode gibt, Leistung zu messen.
Quellen
- Measuring what Matters: Construct Validity in Large Language Model Benchmarks, NeurIPS 2025 Datasets and Benchmarks Track: arxiv.org/abs/2511.04703
- Benchmarking Benchmark Leakage in Large Language Models, Xu, Wang, Fan und Liu: arxiv.org/html/2404.18824v1
Sprechen Sie mit uns