O que uma avaliação de IA realmente mede
Uma nota de benchmark diz como um modelo se saiu num conjunto fixo de perguntas, pontuado de uma forma específica. Ela não diz se o modelo vai funcionar com os seus dados. Uma revisão de 445 benchmarks de modelos de linguagem feita em 2025 concluiu que só 16% aplicaram algum teste estatístico aos resultados, e outro trabalho mostra que cerca de metade dos modelos testados já tinha visto conteúdo dos benchmarks durante o treinamento. Antes de comprar um sistema de IA, monte um pequeno conjunto rotulado com os seus próprios casos reais e meça com base nele.
Toda apresentação de fornecedor de IA tem um gráfico em que a barra dele é mais alta que as outras. O gráfico costuma estar correto. Também costuma ser irrelevante para a pergunta que o comprador de fato está fazendo: se aquilo vai funcionar com os seus próprios documentos, os seus próprios chamados, as suas próprias imagens.
Essa distância não é desonestidade de marketing. É um problema de medição, e ele foi documentado com cuidado suficiente para que você mesmo possa verificá-lo.
Um benchmark é um instrumento, e instrumentos precisam de validação
Nas ciências que medem coisas que não se veem diretamente, um instrumento de medição precisa conquistar confiança antes que as suas leituras signifiquem algo. A propriedade medida precisa estar definida. É preciso mostrar que o teste mede essa propriedade, e não algo correlacionado a ela. O resultado precisa vir com alguma estimativa de quanto dele é ruído. A psicometria chama isso de validade de construto, e é prática comum.
Benchmarks de modelos de linguagem são instrumentos exatamente desse tipo. “Raciocínio” e “utilidade” não são diretamente observáveis, então um benchmark faz as vezes deles. Se esse substituto funciona é uma pergunta que tem resposta, e em 2025 uma equipe de 29 revisores a respondeu para 445 benchmarks de conferências de ponta em processamento de linguagem natural e aprendizado de máquina, num trabalho publicado na trilha Datasets and Benchmarks da NeurIPS 2025.
Vale ler os números com calma:
- 16,0% fizeram algum teste estatístico ou estimativa de incerteza. Os outros 84% informam um número sem nenhuma indicação de quanto ele mudaria se o teste fosse rodado de novo.
- 47,8% dos benchmarks que chegaram a definir o seu alvo mediam um fenômeno controverso, ou seja, algo cuja definição a área não tem consenso.
- 81,3% pontuaram por correspondência exata de texto, e 40,7% não usaram mais nada. Uma resposta correta formulada de outro jeito conta como errada.
- 42,6% reaproveitaram itens de benchmarks existentes, e é assim que uma falha num teste se espalha para os testes que deveriam verificá-lo.
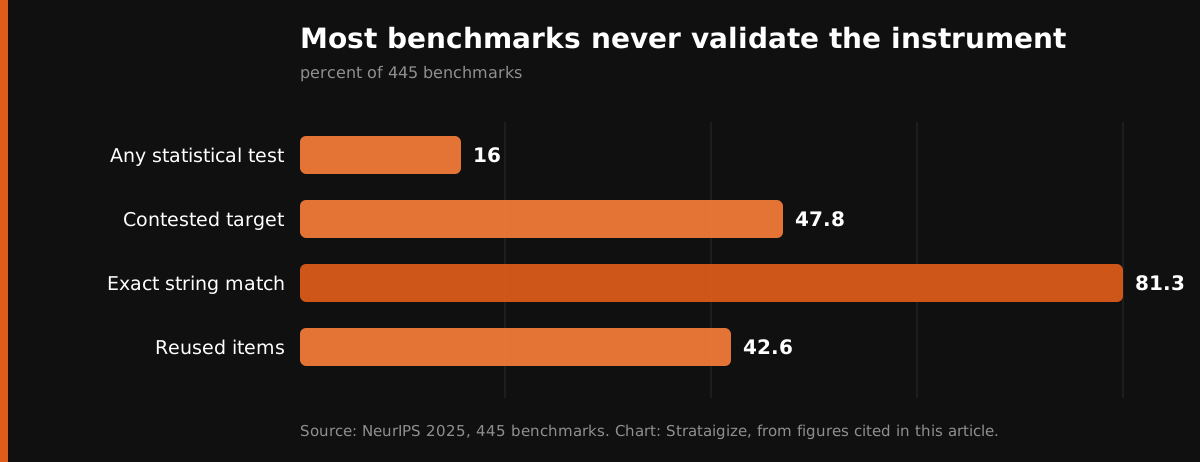
A maioria dos 445 benchmarks nunca validou o instrumento. Fonte: NeurIPS 2025, Measuring what Matters.
Nada disso significa que os benchmarks não valem nada. Significa que uma nota de benchmark é uma afirmação mais fraca do que parece, e a força dessa afirmação raramente aparece ao lado dela.
O problema da contaminação deixa o número ainda mais frágil
Um benchmark só funciona se o modelo ainda não viu as respostas. Os corpora de treinamento modernos são grandes o bastante, e coletados de forma ampla o bastante, para que isso seja difícil de garantir e fácil de errar.
Pesquisadores da Universidade Jiao Tong de Xangai testaram 31 modelos em busca de sinais de vazamento de benchmark no GSM8K e no MATH, dois conjuntos de dados de raciocínio matemático, usando perplexidade e acurácia de previsão de n-gramas para detectar memorização. Cerca de metade mostrou sinais de ter treinado com dados dos benchmarks. No caso mais claro, o Qwen-1.8B reproduziu cada sequência de cinco palavras em 223 exemplos do conjunto de treinamento do GSM8K, 67 do conjunto de treinamento do MATH e 25 do conjunto de teste do MATH, a parte cujo único propósito é não ter sido vista.
Um modelo que memorizou parte de um teste vai pontuar bem nele e não vai dizer nada sobre o desempenho em qualquer outra coisa. Visto de fora, isso é idêntico a um modelo que simplesmente é bom.
Como isso aparecia na pesquisa
O meu doutorado tratou de fazer modelos pré-treinados executarem tarefas visuais para as quais nunca foram treinados, sem exemplos rotulados: encontrar correspondências semânticas com um modelo de difusão na NeurIPS 2023 e depois pontos-chave a partir da mesma classe de modelo na conferência Computer Vision and Pattern Recognition de 2024. Os dois foram medidos em benchmarks rotulados padrão, porque é assim que a área compara métodos.
Esses números eram reais e as comparações eram justas. Mas não respondiam à pergunta que uma empresa faria: se o método funciona com as imagens dela, na resolução dela, com a iluminação dela, segundo a definição dela de resposta correta. Desempenho em benchmark e desempenho em produção são medições diferentes. Quem já levou um modelo de um artigo para um produto viu essa distância.
A avaliação que você mesmo constrói é a única feita para a sua decisão
A solução é pouco glamorosa e funciona. Antes de se comprometer com um sistema de IA, reúna um conjunto de casos reais da sua própria operação e rotule à mão o resultado correto. É a meia jornada mais útil que alguém dedica a um projeto de IA.
Tire amostras da realidade, não dos casos fáceis. Pegue leads reais, chamados reais, faturas reais, fotos reais, incluindo os malformados. Um conjunto tirado só de exemplos limpos mede um sistema que você não tem.
Mire em 100 a 300 itens rotulados para começar. O suficiente para separar um sistema que acerta na maior parte das vezes de um que acerta só um pouco mais que o acaso, e pouco o bastante para que uma pessoa consiga fazer isso numa tarde.
Escreva o que significa correto antes de olhar qualquer resultado. Duas pessoas da mesma equipe muitas vezes discordam sobre se um lead era qualificado ou se um documento foi arquivado corretamente. Resolver essa discordância no papel vale a pena comprando algo ou não, e fazer isso depois significa que a definição se dobra para caber no resultado.
Rotule os casos ambíguos como ambíguos. Forçar uma resposta binária num caso que a sua própria equipe escalaria cria um teste que pune o comportamento correto.
Guarde uma parte. Mantenha uma porção que ninguém que constrói ou ajusta o sistema veja, incluindo o seu fornecedor. Essa parte reservada é a única cuja nota você pode aceitar pelo valor de face.
Registre a taxa de discordância entre os seus próprios rotuladores. Se duas pessoas da sua equipe concordam em 85% das vezes, um sistema com 85% está no nível humano na sua tarefa, e um fornecedor que promete 99% está medindo outra coisa ou viu as suas respostas.
O que perguntar a um fornecedor
As perguntas úteis são sobre o método, não sobre a nota.
Pergunte em que o número informado foi medido e se o sistema foi ajustado nesses mesmos dados. Peça o desempenho nos casos em que ele erra, já que a análise de erros esteve quase ausente dos 445 benchmarks revisados e costuma ser onde mora o risco operacional. Pergunte qual seria o número num conjunto que o fornecedor nunca viu, e então forneça um. Peça um intervalo de confiança, ou o resultado de rodar a avaliação mais de uma vez.
Um fornecedor que consegue responder a isso está fazendo o trabalho. Um fornecedor que responde só com uma posição num ranking disse onde está no teste de outra pessoa.
Como aplicamos isso
Todo sistema do nosso catálogo de sistemas de IA segue uma sequência fixa, e o segundo passo é combinar um conjunto rotulado à mão com os casos reais do próprio cliente antes que alguém fale em horas economizadas. Nada é escalado com base num número de benchmark. A AI Opportunity Audit que abre a maioria dos projetos entrega esse conjunto rotulado, e ele é seu tenhamos ou não construído algo depois.
A avaliação também é o que dá sentido a um limite de interrupção por escrito. Combinar de antemão parar num nível definido de desempenho é uma promessa vazia sem uma forma combinada de medir o desempenho.
Fontes
- Measuring what Matters: Construct Validity in Large Language Model Benchmarks, trilha Datasets and Benchmarks da NeurIPS 2025: arxiv.org/abs/2511.04703
- Benchmarking Benchmark Leakage in Large Language Models, Xu, Wang, Fan e Liu: arxiv.org/html/2404.18824v1
Fale conosco