AI評価が実際に測っているもの
ベンチマークのスコアが教えてくれるのは、ある固定された質問のセットに対して、ある特定の採点方法でモデルがどう振る舞ったかです。そのモデルがあなたのデータで機能するかどうかは教えてくれません。2025年に445件の言語モデルのベンチマークを調べたレビューでは、結果に何らかの統計的検定を行っていたのはわずか16%でした。また別の研究では、テストされたモデルの約半数が学習中にベンチマークの内容をすでに見ていたことが示されています。AIシステムを購入する前に、自社の実際の事例から小さなラベル付きセットを作り、それで測定してください。
AIベンダーの提案資料には、必ず自社の棒が他社より高いグラフが入っています。そのグラフはたいてい正確です。そして、たいてい買い手が本当に知りたいこと、つまり自社の文書、自社のチケット、自社の画像でそれが機能するのかという問いには無関係です。
この隔たりはマーケティングの不誠実さではありません。測定の問題であり、あなた自身で確認できるほど丁寧に記録されています。
ベンチマークは測定器であり、測定器には検証が必要
直接見ることのできないものを測る科学では、測定器の数値が意味を持つ前に、その測定器が信頼を得なければなりません。測る性質が定義されていなければなりません。テストがその性質そのものを測っており、それと相関する別の何かを測っているのではないことが示されなければなりません。結果には、そのうちどれだけがノイズなのかの推定が伴わなければなりません。心理測定学ではこれを構成概念妥当性と呼び、ごく普通の手順です。
言語モデルのベンチマークは、まさにこの種の測定器です。「推論」や「有用性」は直接観察できないので、ベンチマークがその代わりを務めます。その代わりが機能しているかどうかは答えの出る問いで、2025年には29人のレビュアーからなるチームが、自然言語処理と機械学習の主要な学会から集めた445件のベンチマークについてこの問いに答えました。この研究はNeurIPS 2025のDatasets and Benchmarksトラックで発表されています。
数字はゆっくり読む価値があります。
- 16.0% が何らかの統計的検定や不確実性の推定を行っていました。残りの84%は、もう一度実行したらどれだけ変わるのかを示さずに数字を報告しています。
- 目標を定義していたベンチマークのうち 47.8% は、議論のある現象、つまり分野内で定義について合意のないものを測っていました。
- 81.3% が文字列の完全一致で採点しており、40.7%はそれ以外の方法を使っていませんでした。言い回しが違うだけの正解は誤りとして扱われます。
- 42.6% が既存のベンチマークの問題を再利用していました。こうして、あるテストの欠陥が、それを確認するはずだったテストにまで広がります。
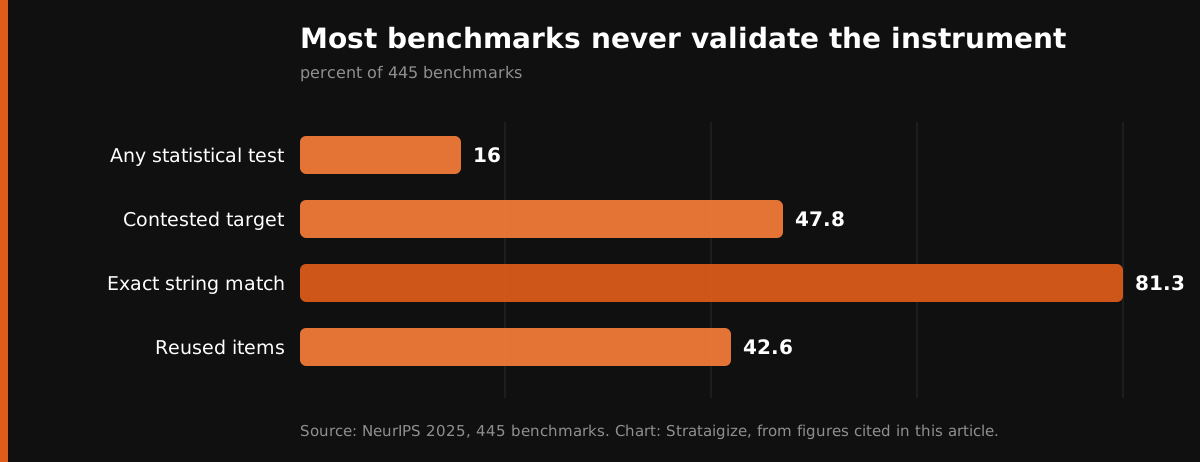
445件のベンチマークの大半は、測定器を一度も検証していませんでした。出典: NeurIPS 2025、Measuring what Matters。
だからといって、ベンチマークに価値がないわけではありません。ベンチマークのスコアは見た目より弱い主張であり、その主張の強さが併記されることはめったにない、ということです。
汚染の問題が数字をさらに頼りないものにする
ベンチマークが機能するのは、モデルがまだ答えを見ていない場合だけです。現代の学習用コーパスは十分に大きく、幅広く収集されているため、これを保証するのは難しく、誤るのは簡単です。
上海交通大学の研究者たちは、数学的推論のデータセットであるGSM8KとMATHについて、31のモデルにベンチマークの漏洩の兆候があるかをテストしました。暗記の検出には、パープレキシティとnグラム予測の精度を使っています。約半数に、ベンチマークのデータで学習した兆候が見られました。最も明白な例では、Qwen-1.8BがGSM8Kの学習用セットの223例、MATHの学習用セットの67例、そしてMATHのテスト用セットの25例で、5語の並びをすべて再現しました。テスト用セットは、見られていないことこそが目的の部分です。
テストの一部を暗記したモデルは、そのテストで高得点を取りますが、それ以外の性能については何も教えてくれません。外から見ると、単に優秀なモデルとまったく同じに見えます。
研究の現場ではどう見えたか
私の博士研究は、事前学習済みのモデルに、ラベル付きの例なしで、学習したことのない視覚タスクをこなさせることでした。まずNeurIPS 2023で拡散モデルを使った意味的対応点の発見を、次に2024年のComputer Vision and Pattern Recognition会議で同じ種類のモデルからのキーポイント抽出を発表しました。どちらも標準的なラベル付きベンチマークで測定しました。分野が手法を比較する方法がそれだからです。
その数字は本物で、比較は公正でした。それでも、企業が知りたい問いには答えられませんでした。その手法が自社の画像で、自社の解像度で、自社の照明条件で、自社の正解の定義のもとで機能するのか、という問いです。ベンチマークでの性能と実運用での性能は別の測定です。論文から製品へモデルを移したことのある人なら、この隔たりを見てきたはずです。
自分で作る評価だけが、あなたの判断に合わせた評価になる
解決策は地味ですが、効果があります。AIシステムの導入を決める前に、自社の業務から実際の事例を集め、正しい結果を手作業でラベル付けしてください。AIプロジェクトで誰かが費やす半日の中で、これが最も役に立ちます。
簡単な事例ではなく、現実からサンプルを取る。 実際のリード、実際のチケット、実際の請求書、実際の写真を、形式の崩れたものも含めて集めます。きれいな例だけで作ったセットは、あなたが持っていないシステムを測ることになります。
まずは100〜300件のラベル付きデータを目標にする。 たいてい正しいシステムと、偶然よりわずかに正しいだけのシステムを見分けるのに十分で、1人が実際に午後だけでこなせる程度の量です。
出力を見る前に、何が正解かを書き出す。 同じチームの2人でも、あるリードが見込みのあるものだったか、ある書類が正しく処理されたかについて意見が割れることはよくあります。その不一致を紙の上で解消することは、何かを買うかどうかにかかわらず価値があります。後からやると、定義が結果に合わせて曲がってしまいます。
曖昧な事例は曖昧としてラベル付けする。 自社のチームならエスカレーションするような事例に二択の答えを押しつけると、正しい振る舞いを罰するテストになります。
一部を取っておく。 システムを構築したり調整したりする人には、ベンダーも含めて誰にも見せない部分を残しておきます。その取り置いた部分のスコアだけが、額面どおりに受け取れるものです。
自社のラベル付け担当者どうしの不一致率を記録する。 自社の2人の意見が85%の確率で一致するなら、85%のスコアを出すシステムはその作業で人間並みの性能を発揮しています。99%を約束するベンダーは、別の何かを測っているか、あなたの答えを見ています。
ベンダーに尋ねるべきこと
役に立つ質問は、スコアではなく方法についてのものです。
報告された数字が何で測定されたのか、そしてシステムがその同じデータで調整されたのかを尋ねてください。間違える事例での性能を求めてください。調査された445件のベンチマークではエラー分析がほとんど行われておらず、運用上のリスクはたいていそこにあります。ベンダーが一度も見たことのないセットでは数字がどうなるかを尋ね、実際にそのセットを渡してください。信頼区間、あるいは評価を複数回実行した結果を求めてください。
これらに答えられるベンダーは、きちんと仕事をしています。ランキングの順位だけで答えるベンダーは、他人のテストで自分が何位かを伝えたにすぎません。
当社での実践
当社のAIシステムのカタログにあるすべてのシステムは、決まった手順で構築されます。その2番目の手順は、削減できる時間について誰かが話す前に、クライアント自身の実際の事例を手作業でラベル付けしたセットを合意することです。ベンチマークの数字をもとに規模を広げることはありません。ほとんどの契約の最初に行うAI Opportunity Auditは、このラベル付きセットを納品物として作成し、その後当社が何かを構築するかどうかにかかわらず、それはあなたのものです。
評価は、書面で定めた中止基準に意味を持たせるものでもあります。定められた性能水準で止めると事前に合意しても、性能を測る方法について合意がなければ空約束です。
出典
- Measuring what Matters: Construct Validity in Large Language Model Benchmarks、NeurIPS 2025 Datasets and Benchmarksトラック: arxiv.org/abs/2511.04703
- Benchmarking Benchmark Leakage in Large Language Models、Xu、Wang、Fan、Liu: arxiv.org/html/2404.18824v1
お問い合わせ