一次 AI 评估实际度量什么
基准分数告诉你模型在一组固定问题上、以某一种计分方式表现如何。它不告诉你模型是否会在你的数据上工作。2025 年对 445 个语言模型基准的综述发现,只有 16% 对其结果做了任何统计检验,另有研究表明约一半被测模型在训练中已见过基准内容。在购买 AI 系统之前,从你自己的真实案例构建一小份标注集,并据此度量。
每份 AI 供应商幻灯片都有一张他们的柱子比其他柱子更高的图。图通常是准确的。对买家真正在问的问题(东西是否会在他们自己的文档、工单、图像上工作)也通常无关。
那个缺口不是营销不诚实。它是测量问题,且已被足够仔细地记录,你可以自己检查。
基准是仪器,仪器需要验证
在那些度量你无法直接看见之物的科学里,测量仪器必须在其读数有意义之前赢得信任。被度量的属性必须被定义。测试必须被证明度量的是该属性,而不是与之相关的别的东西。结果必须带有多少是噪声的某种估计。心理测量学称之为构念效度,这是普通实践。
语言模型基准正是这类仪器。「推理」与「有帮助」不可直接观察,因此基准代替它们。替代是否有效的问题是可回答的,2025 年一支 29 人评审团队在 445 个来自领先自然语言处理与机器学习会议的基准上回答了它,工作发表于 NeurIPS 2025 Datasets and Benchmarks 赛道。
这些数字值得慢慢读:
- 16.0% 做了任何统计检验或不确定性估计。其余 84% 报告一个数字,却不说明再跑一次会移动多少。
- 在有定义目标的基准中,47.8% 度量的是有争议的现象,即该领域对其定义未达成一致。
- 81.3% 用精确字符串匹配计分,且 40.7% 只用这一种。措辞不同的正确答案算错。
- 42.6% 复用现有基准中的题目,于是一个测试中的缺陷会传播到本应检查它的测试中。
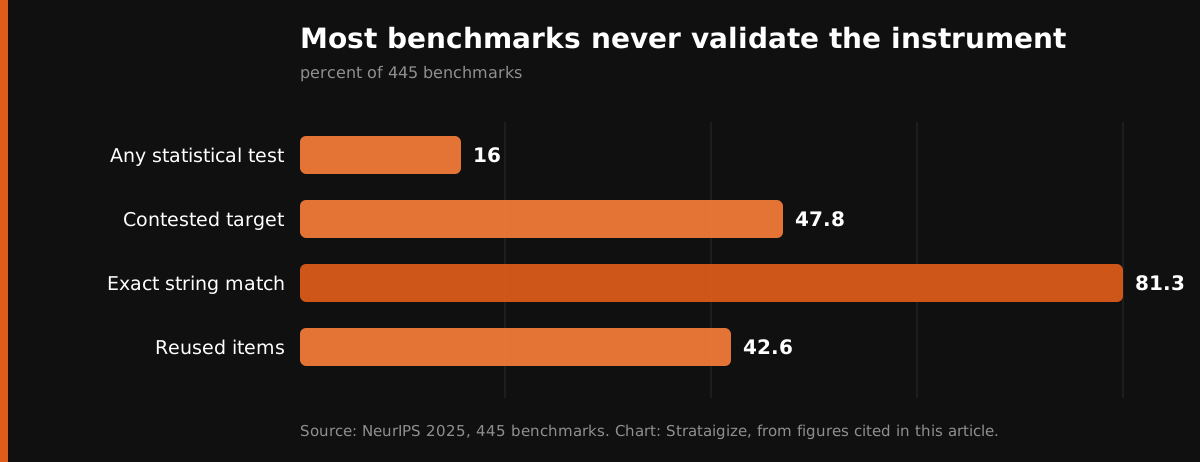
445 个基准中多数从未验证仪器。来源:NeurIPS 2025, Measuring what Matters。
这并不意味着基准毫无价值。它意味着基准分数是比表面更弱的主张,且主张强度很少与之一同陈述。
污染问题使数字更软
基准只有在模型尚未见过答案时才有效。现代训练语料够大、抓取得够广,这很难保证,也容易出错。
上海交通大学的研究人员对 31 个模型测试基准泄漏证据,使用困惑度与 n-gram 预测准确率检测记忆,数据集为 GSM8K 与 MATH 两个数学推理集。约一半显示曾在基准数据上训练的迹象。最清晰的案例中,Qwen-1.8B 复现了 GSM8K 训练集中 223 个样例、MATH 训练集中 67 个样例,以及 MATH 测试集中 25 个样例的每一个五词序列;测试集的全部目的就是保持未见。
记住了部分测试的模型会在其上得分很好,却对其他任何表现什么都不告诉你。从外部看,那与「模型就是好」完全一样。
这在研究中是什么样
我的博士工作是让预训练模型做它们从未被训练过的视觉任务,且无需标注样例:在 NeurIPS 2023 用扩散模型做语义对应,再在 2024 年计算机视觉与模式识别会议上用同一类模型做关键点。两者都对照标准标注基准度量,因为那是该领域比较方法的方式。
那些数字是真实的,比较是公平的。它们也无法回答公司会问的问题:方法是否在他们的图像上、以其分辨率、其光照、其正确答案定义下工作。基准表现与部署表现是不同的测量。任何把模型从论文搬到产品的人都见过这个缺口。
你自己构建的评估,才是唯一对准你决策的评估
修复并不光鲜,但有效。在承诺 AI 系统之前,从你自己的运营中汇集真实案例,并手工标注正确结果。这是任何人在 AI 项目上度过的最有用半天。
从现实抽样,而不是从容易案例。 拉取真实线索、真实工单、真实发票、真实照片,包括畸形的那些。只从干净样例抽出的集合,度量的是你没有的系统。
起步目标 100 至 300 个标注项。 足以区分多数时候正确的系统与略优于随机的系统,又小到一个人一天下午就能做完。
在看任何输出之前写下正确意味着什么。 同一团队里的两个人经常对线索是否合格或文档是否正确归档意见不一。无论买不买东西,在纸上解决分歧都值得做;事后再做意味着定义会弯向结果。
把模糊案例标为模糊。 把你自己团队会升级的案例强行压成二元答案,会构建惩罚正确行为的测试。
留出一部分。 保留一部分对构建或调优系统的任何人(包括供应商)都未见。那份留出部分是你唯一可以照面值接受分数的部分。
记录你自己标注者之间的分歧率。 若你的两个人 85% 一致,得分 85% 的系统在你的任务上已达人类水平,承诺 99% 的供应商要么在度量别的东西,要么见过你的答案。
向供应商问什么
有用的问题关乎方法,而不是分数。
问报告数字是在什么上度量的,以及系统是否在同一数据上调优。问它做错的案例上的表现,因为误差分析在所审的 445 个基准中大多缺失,且通常是运营风险所在。问在供应商从未见过的集合上数字会是多少,然后提供一份。要求置信区间,或要求评估跑不止一次的结果。
能回答这些问题的供应商在做功。只以排行榜位置回应的供应商,告诉你的是他们在别人的测试上排在哪里。
我们如何应用
我们 AI 系统目录 中的每个系统都按固定序列构建,第二步是在任何人讨论节省工时之前,先就客户自己真实案例的手工标注集达成一致。没有任何东西按基准数字规模化。开启多数合作的 AI 机会审计 把该标注集作为交付物产出,无论之后我们是否构建任何东西,它都属于你。
评估也使书面叫停阈值有意义。事先约定在某一表现水平停止,若没有约定的度量方式,就是空话。
来源
- Measuring what Matters: Construct Validity in Large Language Model Benchmarks, NeurIPS 2025 Datasets and Benchmarks track: arxiv.org/abs/2511.04703
- Benchmarking Benchmark Leakage in Large Language Models, Xu, Wang, Fan and Liu: arxiv.org/html/2404.18824v1
联系我们